Technical SEO คือการดูแลโครงสร้างและการตั้งค่าของเว็บไซต์ให้ Google เข้าถึง เก็บข้อมูล (Crawl) และจัดทำดัชนี (Index) หน้าเว็บได้ครบถ้วนและรวดเร็ว ก่อนที่เนื้อหาจะได้แข่งขันเรื่องอันดับ Checklist ฉบับ 2026 นี้เรียงตามลำดับที่ควรตรวจ ได้แก่ ความหมายของ Technical SEO, ข้อกำหนดขั้นต่ำ 3 ข้อของ Google, ภาพรวม Checklist, robots.txt และ XML Sitemap, noindex และ Canonical, Status Code และ Redirect, ความเร็วและ Core Web Vitals, Mobile-first Indexing และ HTTPS, JavaScript SEO, Structured Data, Crawl Budget และการตรวจเว็บด้วย Google Search Console
Technical SEO คืออะไร ต่างจาก On-Page SEO อย่างไร
Technical SEO คือเสาหลักที่ทำให้ Google “เข้าถึงและเข้าใจ” เว็บได้ ส่วน On-Page SEO ทำให้เนื้อหาบนหน้า “ตอบความต้องการ” ของผู้ค้นหา ถ้าเปรียบเว็บเป็นร้านค้า Technical SEO คือทางเข้า ป้าย และทางเดินในร้าน ส่วน On-Page คือสินค้าบนชั้น สินค้าดีแค่ไหนก็ขายไม่ได้ถ้าลูกค้าเดินเข้าร้านไม่ได้ ดูภาพรวมของทั้ง 3 เสาหลักได้ที่ SEO คืออะไร คู่มือ SEO ฉบับสมบูรณ์
งาน Technical SEO ส่วนใหญ่เกิดขึ้นตามขั้นตอนการทำงานของ Google คือ Crawl, Render, Index และ Serve ปัญหาในขั้นแรกจะส่งผลต่อทุกขั้นถัดไป การตรวจจึงควรเริ่มจากคำถามว่า Google เข้ามาเก็บข้อมูลหน้านี้ได้หรือไม่ ก่อนไปถึงเรื่องความเร็วหรือ Schema
ข้อกำหนดขั้นต่ำ 3 ข้อที่ Google ต้องการ
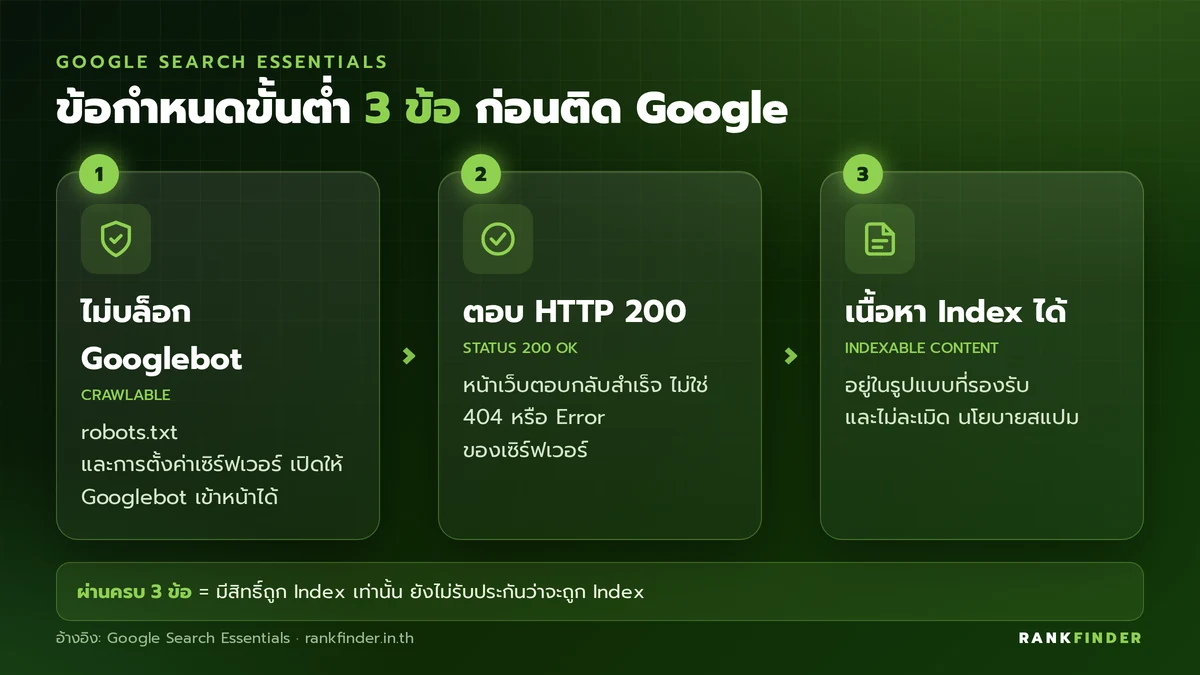
ข้อกำหนดทางเทคนิคขั้นต่ำที่หน้าเว็บต้องผ่านเพื่อมีสิทธิ์แสดงใน Google มี 3 ข้อ ตามเอกสาร Google Search Essentials: Technical requirements ได้แก่ Googlebot ต้องไม่ถูกบล็อก, หน้าเว็บต้องตอบกลับด้วย HTTP 200 และเนื้อหาต้องอยู่ในรูปแบบที่ Index ได้ เอกสารเดียวกันย้ำว่าการผ่าน 3 ข้อนี้ทำให้หน้า “มีสิทธิ์” ถูก Index เท่านั้น ไม่ได้รับประกันว่าจะถูก Index
Technical SEO Checklist 2026 ภาพรวม
Technical SEO Checklist แบ่งเป็น 8 หมวดที่ควรตรวจตามลำดับ ตารางด้านล่างแสดงว่าแต่ละหมวดตรวจอะไรและใช้เครื่องมือใด ก่อนอธิบายรายละเอียดในหัวข้อถัดไป
| หมวด | สิ่งที่ต้องตรวจ | เครื่องมือ |
|---|---|---|
| การเข้าถึง | robots.txt ไม่บล็อกหน้าสำคัญ, XML Sitemap ถูกต้อง | Search Console, ไฟล์ robots.txt |
| การจัดทำดัชนี | noindex ถูกที่, Canonical ชี้หน้าที่ถูกต้อง | Page indexing report, URL Inspection |
| Status Code | ไม่มี 404 ในลิงก์ภายใน, ไม่มี Soft 404, Redirect ไม่เป็นทอดยาว | Crawler เช่น Screaming Frog |
| ความเร็ว | LCP, INP, CLS ผ่านเกณฑ์, TTFB ต่ำ | Core Web Vitals report, PageSpeed Insights |
| มือถือ | เนื้อหาบนมือถือครบเท่าเดสก์ท็อป | URL Inspection (Smartphone) |
| ความปลอดภัย | ทั้งเว็บใช้ HTTPS และ HTTP Redirect ไป HTTPS | เบราว์เซอร์, Crawler |
| JavaScript | เนื้อหาและลิงก์หลักแสดงใน HTML ที่ Render แล้ว | URL Inspection (View crawled page) |
| Structured Data | Schema ถูกต้องและตรงกับเนื้อหาที่แสดง | Rich Results Test |
การเก็บข้อมูล: robots.txt และ XML Sitemap
robots.txt ใช้บอกโปรแกรมเก็บข้อมูลว่าเข้า URL ไหนได้บ้าง ส่วน XML Sitemap ใช้บอก Google ว่าเว็บมีหน้าสำคัญอะไร ทั้งสองไฟล์มีหน้าที่ต่างกันและมักถูกเข้าใจผิด
robots.txt ไม่ได้ใช้ซ่อนหน้าจาก Google
robots.txt ไม่ใช่วิธีกันหน้าออกจากผลการค้นหา เอกสาร Introduction to robots.txt ระบุว่าไฟล์นี้มีไว้จัดการการเข้าเก็บข้อมูลเพื่อไม่ให้เซิร์ฟเวอร์รับภาระเกิน และ URL ที่ถูกบล็อกยังอาจถูก Index ได้ถ้ามีเว็บอื่นลิงก์มา โดยแสดงในผลการค้นหาแบบไม่มีคำอธิบาย ถ้าต้องการกันหน้าออกจาก Google ให้ใช้ noindex หรือตั้งรหัสผ่านแทน ในยุค AI Search ควรตรวจด้วยว่าไม่ได้บล็อกบอตของระบบค้นหา AI ที่ต้องการให้เข้าถึง อ่านเพิ่มที่ GEO และ AI SEO คืออะไร
XML Sitemap ที่ถูกต้องตามเกณฑ์ของ Google
XML Sitemap ที่ถูกต้องต้องมีเฉพาะ URL ที่ต้องการให้ Index และอยู่ในขนาดที่ Google รองรับ เอกสาร Build and submit a sitemap กำหนดให้ Sitemap หนึ่งไฟล์มีได้ไม่เกิน 50,000 URL หรือ 50MB แบบไม่บีบอัด เกินกว่านั้นให้แบ่งไฟล์และใช้ Sitemap Index
- ใช้ URL แบบเต็ม: ระบุ https:// และโดเมนครบ และบันทึกไฟล์เป็น UTF-8
- ตั้ง lastmod ให้ตรงความจริง: Google ใช้ค่า lastmod เมื่อถูกต้องสม่ำเสมอและตรวจสอบได้ และควรเปลี่ยนเมื่อเนื้อหาเปลี่ยนจริง
- ไม่ต้องพึ่ง priority และ changefreq: Google ไม่ใช้ค่าทั้งสองนี้
- ส่งใน Search Console: แล้วตรวจสถานะว่าอ่านไฟล์สำเร็จ
การจัดทำดัชนี: noindex, Canonical และเนื้อหาซ้ำ
การจัดทำดัชนีคือขั้นที่ Google ตัดสินว่าหน้าไหนจะถูกเก็บและหน้าไหนเป็นตัวแทนของกลุ่มหน้าที่คล้ายกัน เอกสาร What is canonicalization อธิบายว่า Google เลือกหน้าหลัก (Canonical) จากหลายสัญญาณ เช่น HTTP หรือ HTTPS, Redirect, การอยู่ใน Sitemap และแท็ก rel=”canonical” และการระบุ Canonical เป็นเพียง “คำใบ้” ไม่ใช่คำสั่ง Google อาจเลือกหน้าอื่นได้
- ให้สัญญาณไปทางเดียวกัน: Canonical, ลิงก์ภายใน, Sitemap และ Redirect ควรชี้ไปที่ URL เดียวกัน
- ใช้ noindex กับหน้าที่ไม่ต้องการให้ค้นเจอ: เช่น หน้าผลการค้นหาภายในเว็บ หน้าขอบคุณหลังส่งฟอร์ม
- อย่าใช้ robots.txt ร่วมกับ noindex ในหน้าเดียวกัน: เพราะ Google จะเข้าไปอ่านแท็ก noindex ไม่ได้
Status Code และ Redirect ที่ถูกต้อง
Status Code ที่ถูกต้องบอก Google ได้ชัดว่าหน้านั้นยังอยู่ ย้ายไปแล้ว หรือถูกลบ เอกสาร How HTTP status codes affect Google Search ระบุว่า Redirect แบบ 301 และ 308 เป็นสัญญาณที่แรงว่าหน้าปลายทางควรเป็นหน้าหลัก ส่วน 302 และ 307 เป็นสัญญาณที่อ่อน หน้าที่ถูก Index แล้วถ้าตอบกลับด้วย 4xx จะถูกนำออกจาก Index และ Googlebot ติดตาม Redirect ได้สูงสุด 10 ทอด
- ย้ายหน้าถาวรใช้ 301: ปลายทางจะถูกมองเป็นหน้าหลักและแสดงในผลการค้นหา
- ย้ายชั่วคราวใช้ 302: URL ต้นทางยังคงแสดงในผลการค้นหา
- ระวัง Soft 404: หน้าที่ตอบ 200 แต่ว่างเปล่าหรือเขียนว่าไม่พบข้อมูล จะถูกมองเป็น Soft 404 ควรตอบด้วย 404 หรือ 410 ให้ตรงความจริง
- ตัดทอด Redirect: ให้ลิงก์ภายในชี้ไปที่ URL ปลายทางโดยตรง
ความเร็วเว็บและ Core Web Vitals
Core Web Vitals คือตัวชี้วัดประสบการณ์การใช้งานจริง 3 ตัวที่ Google ใช้ประเมินหน้าเว็บ ได้แก่ LCP (ความเร็วในการแสดงเนื้อหาหลัก), INP (ความเร็วในการตอบสนองเมื่อผู้ใช้คลิกหรือพิมพ์) และ CLS (ความนิ่งของเลย์เอาต์) เกณฑ์ระดับดีตาม web.dev คือ LCP ไม่เกิน 2.5 วินาที, INP ไม่เกิน 200 มิลลิวินาที และ CLS ไม่เกิน 0.1 โดยวัดที่เปอร์เซ็นไทล์ที่ 75 ของการโหลดหน้าจริง
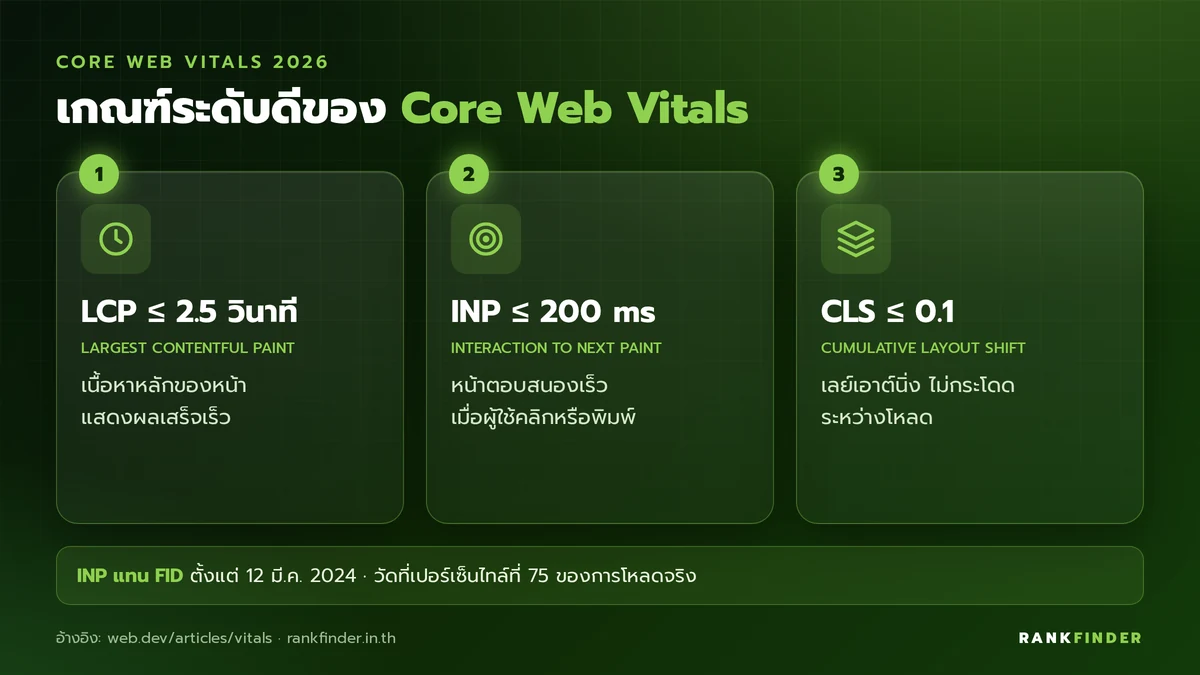
INP เข้ามาแทน FID อย่างเป็นทางการเมื่อวันที่ 12 มีนาคม 2024 ตามประกาศของทีม web.dev บทความ Technical SEO ภาษาไทยหลายแห่งยังอ้างถึง FID อยู่ จึงควรตรวจรายงานด้วยตัวชี้วัดชุดปัจจุบัน เอกสาร Understanding page experience ของ Google ย้ำว่า Core Web Vitals ที่ดีไม่ได้รับประกันอันดับต้น แต่เป็นส่วนหนึ่งของประสบการณ์ที่ระบบจัดอันดับให้รางวัล
ตัวอย่างจากเว็บ Rankfinder เอง เมื่อวันที่ 26 กันยายน 2026 เราตั้งค่า Page Cache และเลื่อนการโหลด JavaScript ที่ไม่จำเป็น ทำให้ Time to First Byte (เวลาที่เซิร์ฟเวอร์เริ่มตอบกลับ) ลดจากประมาณ 0.8 วินาที เหลือประมาณ 0.07 วินาที TTFB ที่ต่ำช่วยให้ LCP ดีขึ้น เพราะเบราว์เซอร์เริ่มโหลดเนื้อหาได้เร็วขึ้น ดูขั้นตอนทั้งหมดของเคสนี้ได้ที่ เว็บ WordPress ช้า แก้อย่างไร
Mobile-first Indexing และ HTTPS
Mobile-first Indexing หมายถึง Google ใช้เนื้อหาเวอร์ชันมือถือของเว็บในการจัดทำดัชนีและจัดอันดับ ตามเอกสาร Mobile-first indexing best practices ดังนั้นเนื้อหา, Structured Data, Title, Meta Description, meta robots และ Alt Text บนมือถือต้องครบเท่ากับเดสก์ท็อป และไม่ควรซ่อนเนื้อหาหลักไว้หลังการคลิกที่ Google โหลดไม่ได้
HTTPS คือมาตรฐานความปลอดภัยที่ทุกหน้าควรใช้ โดย Google ถามไว้ในเอกสาร Understanding page experience ว่าหน้าเว็บให้บริการอย่างปลอดภัยหรือไม่ ให้ตรวจว่าทุก URL แบบ http:// Redirect แบบ 301 ไปยัง https:// และไม่มีรูปหรือสคริปต์ที่ยังโหลดผ่าน http:// (Mixed Content)
JavaScript SEO: ให้ Google เห็นเนื้อหาที่ Render แล้ว
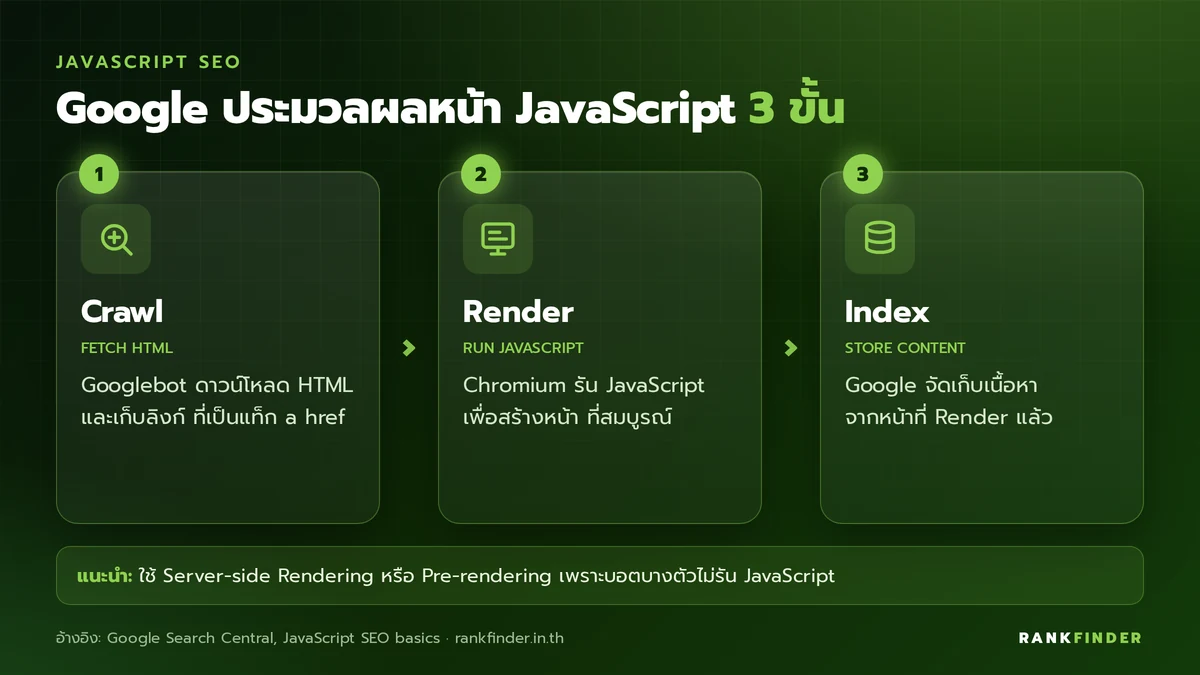
JavaScript SEO คือการทำให้เนื้อหาที่สร้างด้วย JavaScript ถูก Google เก็บข้อมูลและ Index ได้ครบ เอกสาร JavaScript SEO basics อธิบายว่า Google ประมวลผลหน้าเว็บ JavaScript 3 ขั้น คือ Crawl, Render และ Index และยังแนะนำ Server-side Rendering หรือ Pre-rendering เพราะไม่ใช่บอตทุกตัวที่รัน JavaScript ได้
- ลิงก์ต้องเป็นแท็ก <a href>: ลิงก์ที่ทำงานด้วย onclick อย่างเดียว Google อาจติดตามไม่ได้
- อย่าใช้ JavaScript ลบ noindex: Google อาจข้ามการ Render หน้าที่มี noindex ตั้งแต่แรก
- ตรวจหน้าที่ Render แล้ว: ใช้ URL Inspection ดูว่าเนื้อหาหลักปรากฏใน HTML ที่ Google เห็นหรือไม่
Structured Data ที่ถูกต้องตามแนวทางของ Google
Structured Data คือโค้ดที่อธิบายเนื้อหาบนหน้าให้ Google เข้าใจเป็นข้อมูลที่มีโครงสร้าง เช่น บทความ สินค้า หรือคำถามที่พบบ่อย เอกสาร General structured data guidelines แนะนำรูปแบบ JSON-LD และกำหนดว่าห้าม Markup เนื้อหาที่ผู้อ่านมองไม่เห็นบนหน้า การละเมิดอาจทำให้เว็บเสียสิทธิ์แสดง Rich Results ดูวิธีเลือกและติดตั้ง Schema ได้ที่ คู่มือ Schema Markup
Crawl Budget: เว็บแบบไหนต้องสนใจ
Crawl Budget เป็นเรื่องที่เว็บขนาดใหญ่เท่านั้นต้องจัดการ เอกสาร Crawl budget management for large sites ระบุกลุ่มเป้าหมายไว้ 3 แบบ คือ เว็บที่มีมากกว่า 1 ล้านหน้าและเปลี่ยนเนื้อหาราวสัปดาห์ละครั้ง, เว็บที่มีมากกว่า 10,000 หน้าและเปลี่ยนเนื้อหาทุกวัน และเว็บที่มี URL สถานะ “Discovered – currently not indexed” จำนวนมาก ถ้าหน้าใหม่ของเว็บถูกเก็บข้อมูลภายในวันที่เผยแพร่ ก็ไม่จำเป็นต้องกังวลเรื่องนี้
ตรวจ Technical SEO ด้วย Google Search Console
Google Search Console คือเครื่องมือหลักในการตรวจ Technical SEO เพราะแสดงมุมมองจากฝั่ง Google โดยตรง รายงานที่ควรเปิดดูทุกเดือนมี 3 ตัว
- Page indexing report: ดูจำนวนหน้าที่ถูกและไม่ถูก Index พร้อมเหตุผล เช่น Excluded by noindex, Blocked by robots.txt, Soft 404 และ Crawled – currently not indexed หน้าช่วยเหลือ Page indexing report ระบุว่าไม่ควรคาดหวังให้ทุก URL ถูก Index แต่ควรเป็นหน้า Canonical ทั้งหมด
- URL Inspection: ตรวจหน้ารายหน้า ดูสถานะการ Index, ภาพหน้าที่ Render แล้ว และขอให้ Index ใหม่ โดย หน้าช่วยเหลือ URL Inspection ระบุว่าการขอ Index ไม่รับประกันว่าหน้าจะถูก Index
- Core Web Vitals report: ดูกลุ่ม URL ที่ความเร็วไม่ผ่านเกณฑ์ แยกมือถือและเดสก์ท็อป
สำหรับเว็บที่มีปัญหาหลายจุดพร้อมกัน การจัดลำดับการแก้ไขสำคัญพอ ๆ กับการหาปัญหา ทีม Rankfinder มีบริการ SEOที่เริ่มจากการตรวจ Technical SEO ทั้งเว็บ หรือถ้าต้องการให้ทีมภายในตรวจเองได้ ดูคอร์สเรียน SEO
ประเด็นสำคัญของ Technical SEO
- ความหมาย: Technical SEO ทำให้ Google เข้าถึง เก็บข้อมูล และ Index เว็บได้ครบ ก่อนเนื้อหาจะได้แข่งอันดับ
- ข้อกำหนดขั้นต่ำ: ไม่บล็อก Googlebot, ตอบ HTTP 200 และเนื้อหา Index ได้
- Checklist: ตรวจ 8 หมวดตามลำดับ ตั้งแต่การเข้าถึงจนถึง Structured Data
- robots.txt และ Sitemap: robots.txt ไม่ได้ซ่อนหน้า Sitemap ไม่เกิน 50,000 URL หรือ 50MB
- Canonical: เป็นคำใบ้ ต้องให้ทุกสัญญาณชี้ URL เดียวกัน
- Redirect: 301 สำหรับย้ายถาวร 302 สำหรับชั่วคราว และระวัง Soft 404
- Core Web Vitals: LCP ไม่เกิน 2.5 วินาที INP ไม่เกิน 200 มิลลิวินาที CLS ไม่เกิน 0.1
- มือถือและ HTTPS: เนื้อหามือถือต้องครบ และทุกหน้าใช้ HTTPS
- JavaScript: ลิงก์เป็น <a href> และตรวจเนื้อหาที่ Render แล้ว
- Structured Data: ใช้ JSON-LD และตรงกับเนื้อหาที่มองเห็น
- Crawl Budget: สำคัญเฉพาะเว็บขนาดใหญ่มาก
- Search Console: ตรวจ Page indexing, URL Inspection และ Core Web Vitals ทุกเดือน
คำถามที่พบบ่อยเกี่ยวกับ Technical SEO
Technical SEO ต้องเขียนโค้ดเป็นไหม
Technical SEO ส่วนใหญ่ไม่ต้องเขียนโค้ด เว็บ WordPress ตั้งค่า Sitemap, Canonical, noindex และ Schema ผ่านปลั๊กอินอย่าง Rank Math ได้ แต่งานอย่างแก้ความเร็วเซิร์ฟเวอร์หรือ JavaScript Rendering มักต้องทำร่วมกับนักพัฒนาเว็บ
ควรตรวจ Technical SEO บ่อยแค่ไหน
ควรดูรายงานใน Search Console ทุกเดือน และตรวจทั้งเว็บด้วย Crawler อย่างน้อยทุกไตรมาส รวมถึงทุกครั้งที่เปลี่ยนธีม ย้ายโฮสติ้ง หรือเปลี่ยนโครงสร้าง URL
Technical SEO กับ SEO Audit ต่างกันอย่างไร
Technical SEO คืองานดูแลโครงสร้างเว็บที่ทำต่อเนื่อง ส่วน SEO Audit คือการตรวจสุขภาพเว็บครั้งใหญ่ที่ครอบคลุมทั้ง Technical, On-Page และ Backlink เพื่อหาปัญหาและจัดลำดับงาน การตรวจ Technical SEO จึงเป็นส่วนหนึ่งของ SEO Audit
กด Request Indexing แล้วหน้าจะติด Google ทันทีไหม
การกด Request Indexing ไม่ได้ทำให้หน้าติด Google ทันที Google ระบุว่าการขอไม่รับประกันการ Index และมีโควตาการขอต่อวัน วิธีที่ยั่งยืนกว่าคือทำให้หน้ามีลิงก์ภายในจากหน้าสำคัญและอยู่ใน XML Sitemap