หน้าเว็บไม่ถูก Index คือหน้าที่ Google รู้จักหรือเข้ามาอ่านแล้ว แต่ยังไม่ได้เก็บเข้าดัชนีการค้นหา หน้านั้นจึงไม่แสดงใน Google ไม่ว่าจะค้นด้วยคำใด สถานะที่ทำให้เจ้าของเว็บสับสนบ่อยใน Search Console คือ Crawled – currently not indexed ซึ่งแปลว่า Google อ่านหน้าแล้วแต่เลือกยังไม่เก็บ บทความนี้เรียงเนื้อหาตามลำดับการแก้ ได้แก่ หน้าเว็บไม่ถูก Index หมายความว่าอะไร, วิธีเช็กว่าหน้าไหนไม่ถูก Index ใน Search Console, Crawled – currently not indexed เกิดจากอะไร, Discovered – currently not indexed ต่างกันอย่างไร, วิธีแก้ Crawled – currently not indexed ทีละขั้น, ขอให้ Google ตรวจหน้าอีกครั้งหลังแก้ และหน้าแบบไหนไม่ต้องรีบแก้
หน้าเว็บไม่ถูก Index หมายความว่าอะไร
หน้าเว็บไม่ถูก Index หมายความว่า Google ยังไม่ได้เก็บหน้านั้นไว้ในฐานข้อมูลที่ใช้ตอบคำค้น หน้านั้นจึงยังไม่มีสิทธิ์ติดอันดับเลย ก่อนที่หน้าใดจะขึ้นในผลการค้นหา ต้องผ่าน 3 ขั้น คือ Google ค้นพบและเข้ามาอ่านหน้า (Crawl), วิเคราะห์แล้วเก็บเข้าดัชนี (Index) และนำไปแสดงเมื่อมีคนค้นหา (Serve) ปัญหาในบทความนี้เกิดที่ขั้นที่สอง ซึ่งเป็นงานของ Technical SEO โดยตรง ถ้าอยากเห็นภาพรวมของงานส่วนนี้ทั้งหมด อ่านคู่มือTechnical SEOของเราประกอบได้
การไม่ถูก Index ไม่ได้แปลว่าเว็บโดนลงโทษเสมอไป คู่มือการทำงานของ Google Search ระบุว่าการจัดทำดัชนีไม่มีการรับประกัน ไม่ใช่ทุกหน้าที่ Google ประมวลผลจะถูกจัดทำดัชนี และผลขึ้นอยู่กับเนื้อหาของหน้าและ Metadata ด้วย คู่มือเดียวกันยกตัวอย่างปัญหาที่พบบ่อย 3 แบบ ได้แก่ เนื้อหาในหน้ามีคุณภาพต่ำ, กฎ robots meta ไม่อนุญาตให้จัดทำดัชนี และการออกแบบเว็บที่ทำให้จัดทำดัชนีได้ยาก
วิธีเช็กว่าหน้าไหนไม่ถูก Index ใน Search Console
วิธีเช็กที่แม่นที่สุดคือเปิดรายงานการจัดทำดัชนีหน้าเว็บ (Page indexing) ใน Google Search Console แล้วดูตาราง Why pages aren’t indexed ซึ่งแยก URL ที่ไม่ถูก Index ตามสาเหตุ ทำตามลำดับนี้
- เปิดรายงาน: ใน Search Console ไปที่เมนู Indexing > Pages (การจัดทำดัชนี > หน้าเว็บ) กราฟด้านบนแสดงจำนวนหน้าที่ถูก Index และไม่ถูก Index
- ดูสาเหตุ: เลื่อนลงไปที่ตาราง Why pages aren’t indexed แล้วคลิกแต่ละแถว คู่มือรายงาน Page indexing ของ Google อธิบายว่าหน้ารายละเอียดจะแสดง URL ที่เจอปัญหานั้นและประวัติของปัญหาในเว็บ
- กรองเฉพาะหน้าใน Sitemap: เปลี่ยนตัวกรองด้านบนจาก All known pages เป็น All submitted pages ตัวกรองแรกแสดงทุก URL ที่ Google รู้จัก ส่วนตัวกรองหลังแสดงเฉพาะ URL ใน Sitemap ที่ส่งไว้ ซึ่งควรเป็นหน้าที่คุณอยากให้ติดจริง
- ตรวจรายหน้า: นำ URL ที่สงสัยไปวางในช่องค้นหาด้านบนสุดของ Search Console เพื่อเปิดเครื่องมือตรวจสอบ URL (URL Inspection) แล้วดูสถานะของหน้านั้นโดยตรง
สถานะในตารางมีหลายแบบ และแต่ละแบบแก้คนละทาง ตารางด้านล่างสรุปความหมายตามคู่มือของ Google กับสิ่งที่ควรทำ
| สถานะใน Search Console | ความหมาย | ควรทำอะไร |
|---|---|---|
| Crawled – currently not indexed | Google อ่านหน้าแล้วแต่ยังไม่เก็บ อาจเก็บหรือไม่เก็บในอนาคต | ปรับคุณภาพเนื้อหาและลิงก์ภายในของหน้า |
| Discovered – currently not indexed | Google พบ URL แล้วแต่ยังไม่ได้เข้ามาอ่าน | ตรวจความพร้อมของเซิร์ฟเวอร์และลด URL ที่ไม่จำเป็น |
| Duplicate without user-selected canonical | หน้าซ้ำกับหน้าอื่นและไม่ได้ระบุหน้าหลัก | ใส่ Canonical ชี้ไปที่หน้าหลัก |
| Duplicate, Google chose different canonical than user | Google เลือกหน้าอื่นเป็นหน้าหลักแทนหน้าที่เราระบุ | ทำให้เนื้อหาต่างกันชัดเจน หรือรวมหน้าเข้าด้วยกัน |
| URL marked ‘noindex’ | Google เจอคำสั่ง noindex ในหน้า | เอา noindex ออกถ้าต้องการให้หน้านี้ติด |
| Blocked by robots.txt | ไฟล์ robots.txt บล็อกไม่ให้อ่านหน้า | แก้กฎ Disallow ที่ครอบหน้านี้ |
| Soft 404 | หน้าแสดงข้อความว่าไม่พบ แต่ไม่ได้ตอบรหัส 404 | ตอบรหัส 404 จริง หรือเพิ่มเนื้อหาให้ชัดว่าหน้ายังใช้งานอยู่ |
สำหรับ Soft 404 คู่มือของ Google แนะนำให้หน้าที่ไม่มีอยู่จริงตอบรหัส 404 ส่วนหน้าที่ยังใช้งานอยู่ให้เพิ่มข้อมูลในหน้าเพื่อบอก Google ว่าไม่ใช่หน้าว่าง ส่วนสองสถานะแรกในตารางเป็นเรื่องที่เจ้าของเว็บถามบ่อยที่สุด จึงอธิบายแยกในหัวข้อถัดไป
Crawled – currently not indexed เกิดจากอะไร
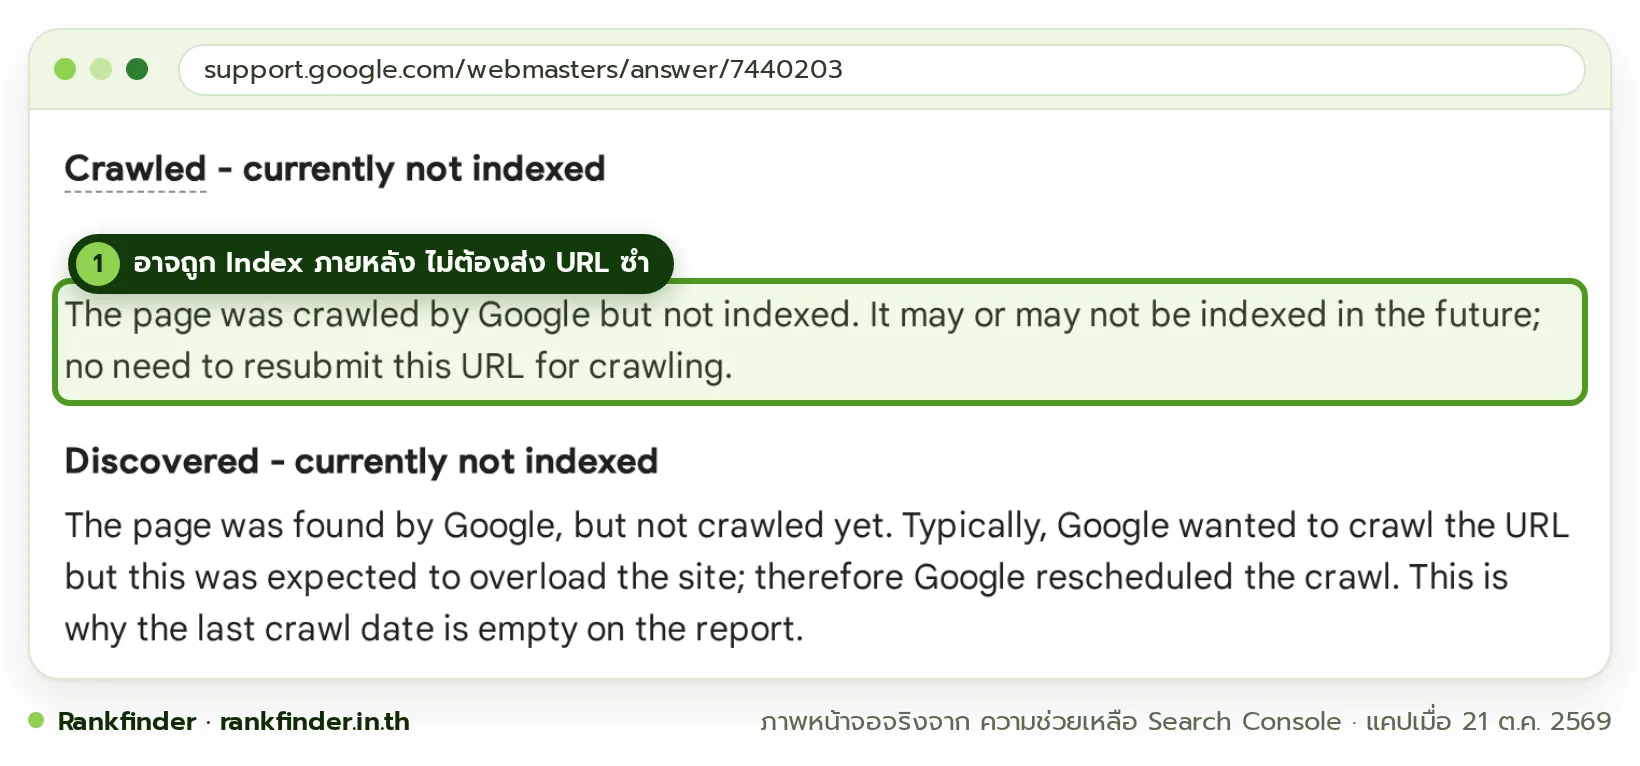
Crawled – currently not indexed เกิดจาก Google เข้ามาอ่านหน้าแล้ว แต่ตัดสินว่ายังไม่เก็บหน้านั้นเข้าดัชนีในตอนนี้ คู่มือรายงาน Page indexing ระบุว่าหน้าแบบนี้อาจถูกจัดทำดัชนีหรือไม่ก็ได้ในอนาคต และไม่จำเป็นต้องส่ง URL ให้ Google รวบรวมข้อมูลซ้ำ แปลว่าการกดส่งหน้าเดิมโดยไม่แก้อะไรไม่ช่วย สิ่งที่ต้องทำคือหาว่าทำไม Google ยังไม่อยากเก็บหน้านี้
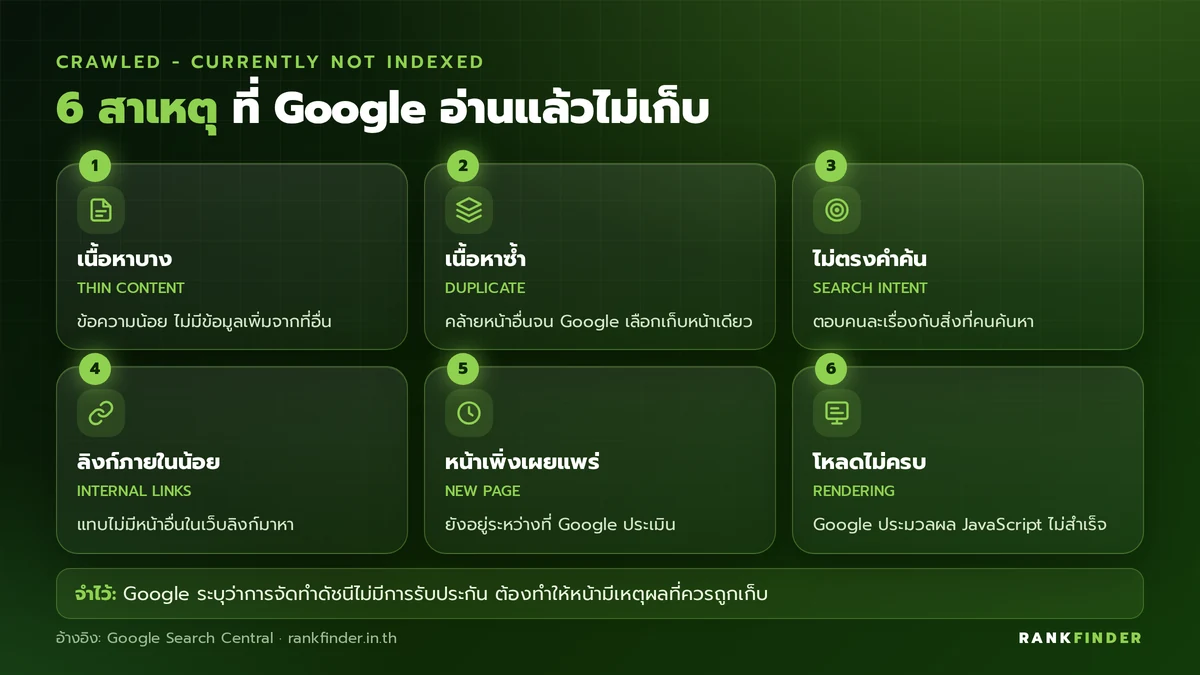
Google ไม่ได้ระบุสาเหตุรายหน้าในรายงาน แต่เมื่อเทียบกับปัญหาการจัดทำดัชนีที่ Google ยกตัวอย่างไว้ สาเหตุที่ตรวจเจอในทางปฏิบัติแบ่งได้ 6 กลุ่ม
- เนื้อหาบาง: หน้ามีข้อความน้อย หรือมีแต่ข้อมูลที่หาได้ทั่วไปโดยไม่มีอะไรเพิ่ม
- เนื้อหาซ้ำหรือคล้ายหน้าอื่น: คู่มือของ Google อธิบายว่าระหว่างจัดทำดัชนี Google จะจัดกลุ่มหน้าที่เนื้อหาคล้ายกัน แล้วเลือกหน้าที่เป็นตัวแทนของกลุ่มได้ดีที่สุดเพียงหน้าเดียว หน้าอื่นในกลุ่มจึงไม่ถูกแสดง
- ไม่ตรงความตั้งใจของผู้ค้นหา: หน้าตอบคำถามที่ไม่มีใครค้น หรือตอบคนละเรื่องกับหัวข้อ
- ลิงก์ภายในน้อย: หน้าแทบไม่มีลิงก์จากหน้าอื่นในเว็บ Google จึงมองว่าเป็นหน้าที่เว็บเองไม่ได้ให้ความสำคัญ
- หน้าเพิ่งเผยแพร่: หน้าใหม่บางหน้าอยู่ในสถานะนี้ช่วงหนึ่งก่อน Google ตัดสินใจเก็บ
- เนื้อหาหลักโหลดไม่ครบ: เนื้อหาสำคัญแสดงด้วย JavaScript ที่ Google ประมวลผลไม่สำเร็จ หรือ Template มีส่วนประกอบมากกว่าเนื้อหาจริง
สาเหตุที่เจอบ่อยในเว็บธุรกิจคือหน้าที่เขียนเรื่องเดียวกันซ้ำหลายหน้า เช่น บทความ 3 บทที่ตอบคำถามเดียวกันด้วยถ้อยคำต่างกันเล็กน้อย Google เลือกเก็บไว้หน้าเดียว หน้าที่เหลือจึงค้างอยู่ในสถานะนี้
Discovered – currently not indexed ต่างกันอย่างไร
Discovered – currently not indexed ต่างจาก Crawled – currently not indexed ตรงที่ Google ยังไม่ได้เข้ามาอ่านหน้าเลย คู่มือรายงานของ Google อธิบายว่า Google พบ URL แล้วแต่ยังไม่ได้รวบรวมข้อมูล โดยปกติเป็นเพราะ Google ต้องการรวบรวมข้อมูล URL นั้น แต่คาดว่าจะทำให้เว็บรับภาระมากเกินไป จึงเลื่อนการรวบรวมข้อมูลออกไป ช่องวันที่รวบรวมข้อมูลล่าสุดในรายงานจึงว่าง
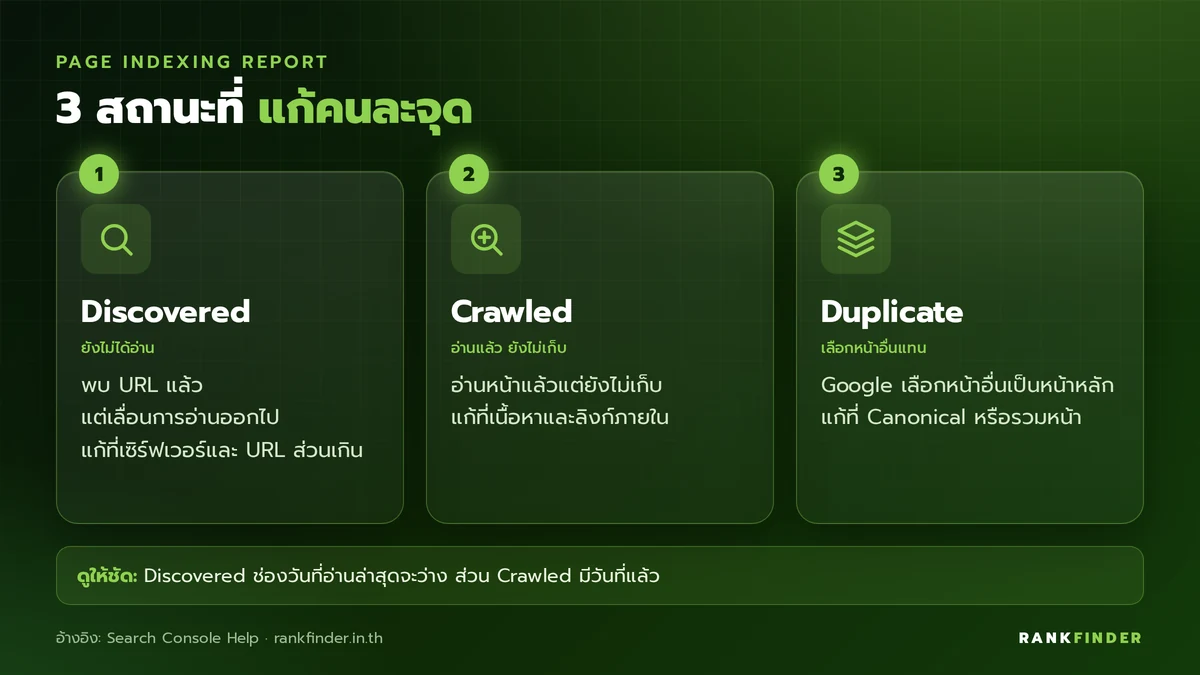
สองสถานะนี้จึงแก้คนละจุด Crawled ต้องแก้ที่ตัวหน้า ส่วน Discovered ต้องแก้ที่ความสามารถของเว็บในการรับบอต ถ้ายังไม่แน่ใจว่าcrawl คืออะไรและ Googlebot เลือกหน้าที่จะเข้าไปอ่านอย่างไร ให้เริ่มจากพื้นฐานนี้ก่อน แล้วตรวจ 3 เรื่องต่อไปนี้
- ความเร็วและความเสถียรของเซิร์ฟเวอร์: ดูรายงาน Crawl stats ใน Search Console (Settings > Crawl stats) ว่ามีข้อผิดพลาดของเซิร์ฟเวอร์หรือเวลาตอบสนองสูงผิดปกติหรือไม่
- จำนวน URL ที่ไม่จำเป็น: URL จากตัวกรองสินค้า พารามิเตอร์ หรือหน้าแท็กที่ไม่มีเนื้อหา ทำให้บอตต้องแบ่งเวลาไปอ่านหน้าที่ไม่มีประโยชน์
- เส้นทางลิงก์ไปถึงหน้า: หน้าที่อยู่ลึกหลายชั้นหรือมีแต่ใน Sitemap โดยไม่มีลิงก์จากหน้าอื่น จะถูกจัดลำดับให้อ่านทีหลัง
วิธีแก้ Crawled – currently not indexed ทีละขั้น
วิธีแก้คือไล่ตรวจเรื่องทางเทคนิคที่ตรวจได้เร็วก่อน แล้วจึงปรับเนื้อหาและลิงก์ภายใน เพราะถ้าหน้ายังติด noindex หรือ Canonical ชี้ไปหน้าอื่น การปรับเนื้อหาเท่าไรก็ไม่ช่วย ทำตามลำดับนี้
- ทดสอบหน้าจริงด้วย URL Inspection: กด Test live URL แล้วตรวจว่าหน้าตอบรหัส 200, ไม่มี noindex และไม่ถูก robots.txt บล็อก คู่มือเครื่องมือตรวจสอบ URL ระบุว่าการทดสอบนี้ดึงหน้าแบบเรียลไทม์ ส่วนผลด้านบนเป็นข้อมูลจากครั้งล่าสุดที่จัดทำดัชนี
- เทียบ Canonical: ในผลตรวจสอบ ดูว่า User-declared canonical (ที่เราระบุ) ตรงกับ Google-selected canonical (ที่ Google เลือก) หรือไม่ ถ้าไม่ตรง แปลว่า Google มองว่ามีหน้าอื่นที่เป็นตัวแทนเนื้อหานี้ได้ดีกว่า
- รวมหรือตัดหน้าที่ซ้ำ: ถ้ามีหลายหน้าตอบเรื่องเดียวกัน ให้รวมเนื้อหาไว้หน้าที่ดีที่สุด แล้วทำ Redirect 301 จากหน้าอื่น หรือใส่ Canonical ตามคู่มือการรวม URL ที่ซ้ำกันของ Google
- เพิ่มสิ่งที่มีแต่หน้านี้: ใส่ข้อมูล ตัวอย่าง หรือขั้นตอนที่ผู้อ่านหาจากหน้าอื่นไม่ได้ คู่มือการสร้างเนื้อหาที่เป็นประโยชน์ของ Google มีชุดคำถามให้ประเมินเอง เช่น เนื้อหาให้ข้อมูลหรือการวิเคราะห์ที่เป็นของตัวเองหรือไม่
- เพิ่มลิงก์จากหน้าที่เกี่ยวข้อง: ใส่ลิงก์ภายในจากบทความหรือหน้าบริการที่พูดเรื่องใกล้เคียง โดยใช้ข้อความลิงก์ที่บอกว่าหน้าปลายทางเกี่ยวกับอะไร
- ใส่ URL ไว้ใน Sitemap: ตรวจว่าหน้านี้อยู่ใน Sitemap ที่ส่งไว้แล้ว และ Sitemap ไม่มีหน้าที่ตั้ง noindex ปนอยู่
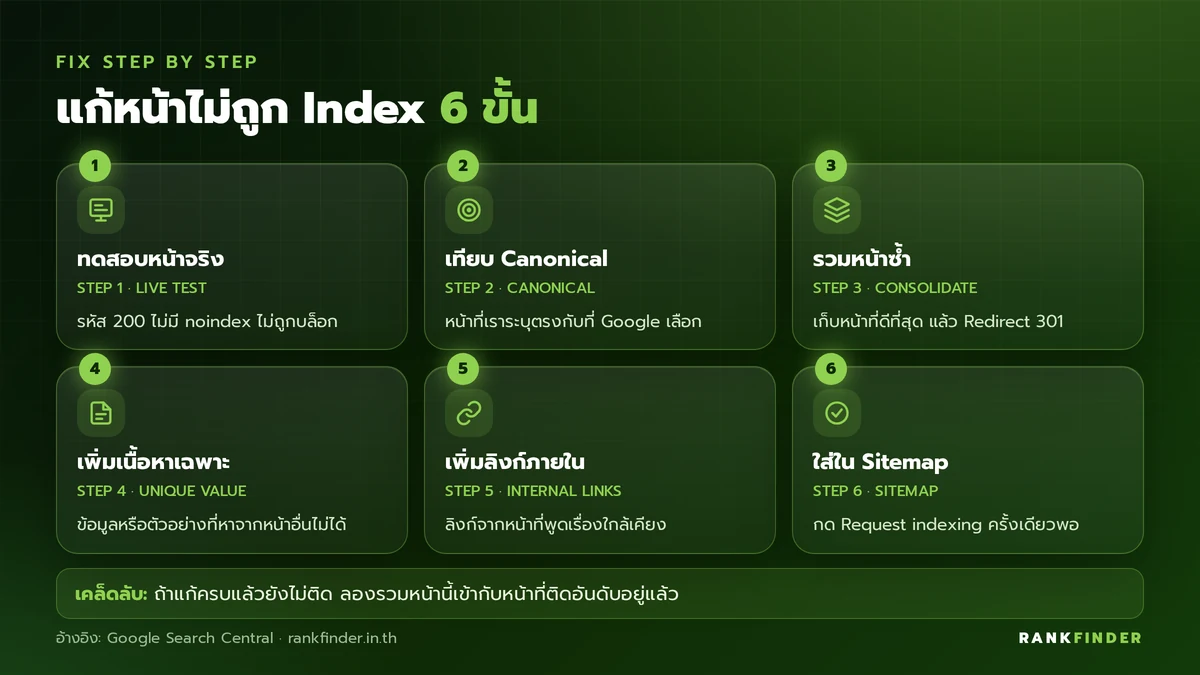
ถ้าตรวจครบทั้ง 6 ข้อแล้วหน้ายังไม่ถูก Index ให้ถามตัวเองตรงๆ ว่าหน้านี้จำเป็นต้องมีแยกหรือไม่ บางครั้งคำตอบที่ถูกคือรวมเข้ากับหน้าที่ติดอันดับอยู่แล้ว ซึ่งได้ผลดีกว่าการพยายามดันหน้าที่ซ้ำกันให้ติดทั้งคู่
ขอให้ Google ตรวจหน้าอีกครั้งหลังแก้
หลังแก้เสร็จ ให้ขอ Google ตรวจอีกครั้งด้วย 2 เครื่องมือใน Search Console คือ Request indexing ในเครื่องมือตรวจสอบ URL สำหรับหน้าเดียว และปุ่ม Validate fix (ตรวจสอบการแก้ไข) ในรายงาน Page indexing สำหรับ URL ทั้งกลุ่มที่เจอปัญหาเดียวกัน ถ้ายังไม่เคยใช้เครื่องมือนี้ ลองอ่านก่อนว่าSearch Console คืออะไรและตั้งค่าอย่างไร แล้วค่อยกลับมาทำขั้นนี้
- Request indexing มีโควตา: คู่มือเครื่องมือตรวจสอบ URL ระบุว่ามีขีดจำกัดจำนวนคำขอต่อวัน การส่งคำขอไม่ได้รับประกันว่าหน้าจะเข้าดัชนี และกดขอไม่ได้ถ้าการทดสอบหน้าจริงพบว่าหน้านั้นจัดทำดัชนีไม่ได้
- กดซ้ำไม่ช่วยให้เร็วขึ้น: คู่มือการขอให้ Google รวบรวมข้อมูลอีกครั้ง ระบุว่าการรวบรวมข้อมูลใช้เวลาตั้งแต่ไม่กี่วันถึงไม่กี่สัปดาห์ และการขอซ้ำหลายครั้งสำหรับ URL เดิมไม่ทำให้รวบรวมข้อมูลเร็วขึ้น
- Validate fix ใช้เวลา: คู่มือรายงาน Page indexing ระบุว่าการตรวจสอบมักใช้เวลาไม่เกินประมาณสองสัปดาห์ แต่บางกรณีนานกว่านั้นมาก และห้ามกด Validate fix ซ้ำจนกว่าผลจะสำเร็จหรือไม่สำเร็จ
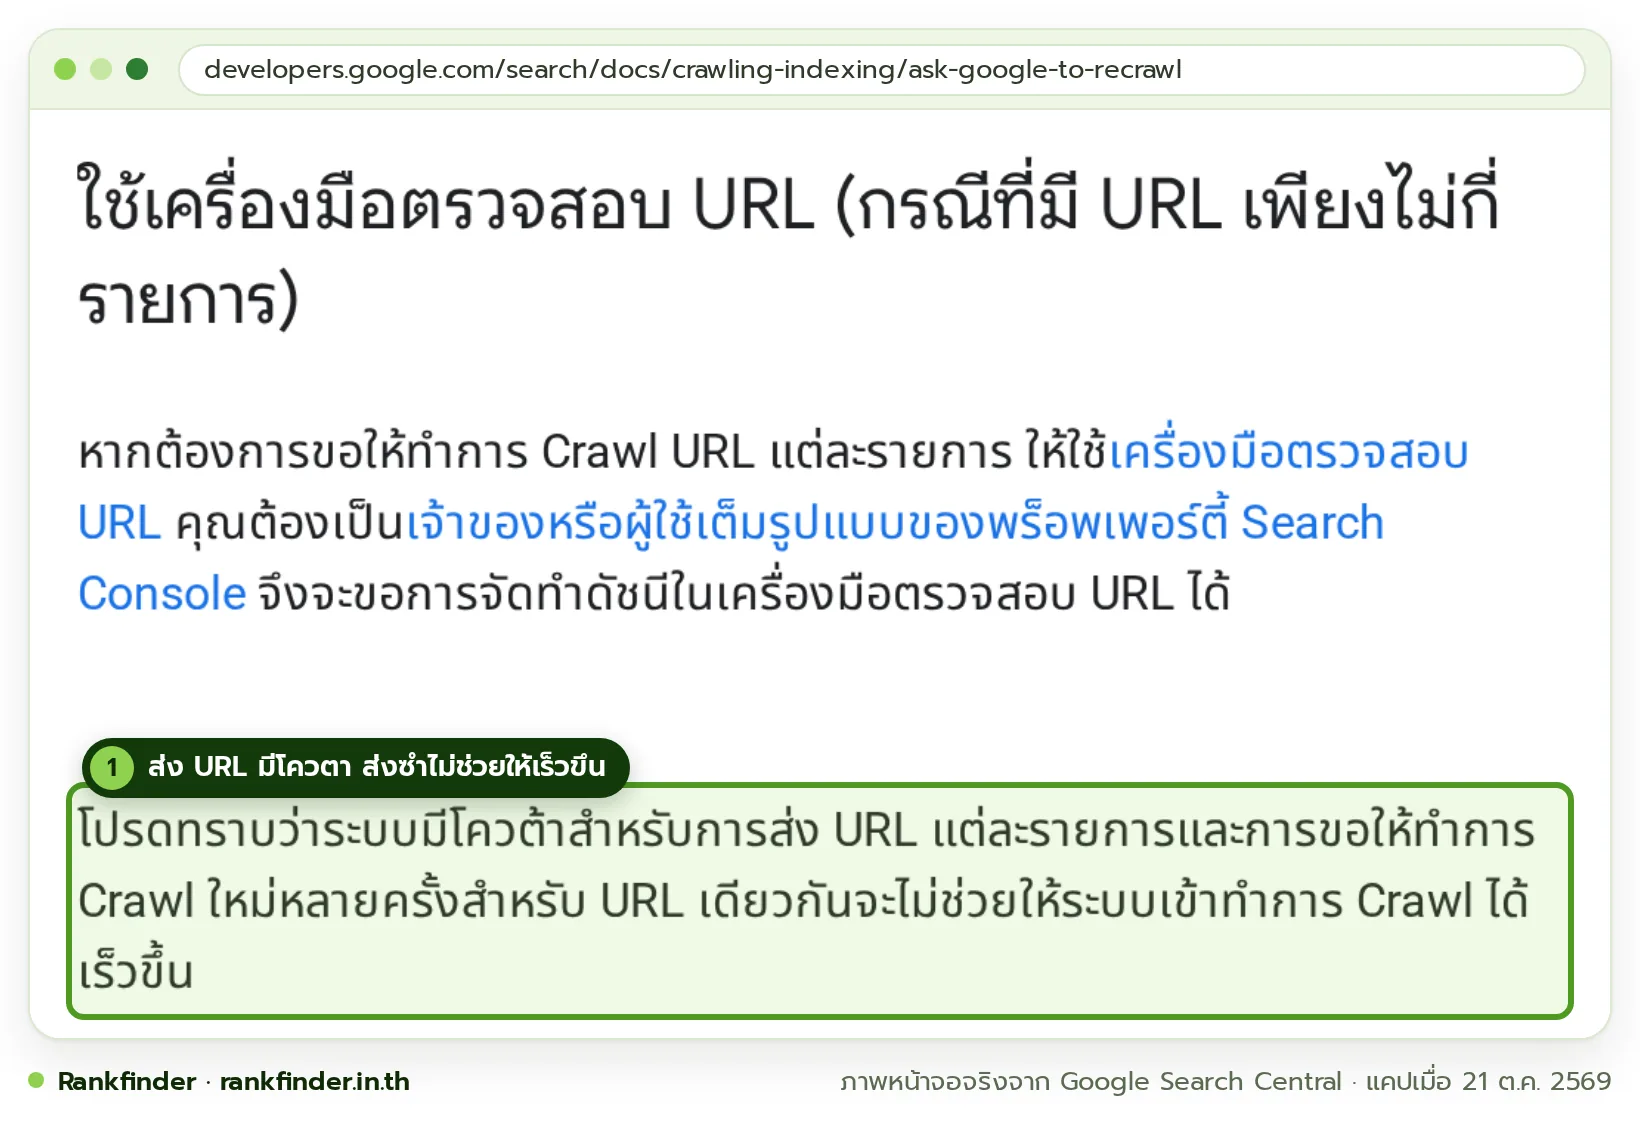
ระหว่างรอ ให้ใช้เวลานี้แก้หน้าอื่นที่มีปัญหาเดียวกัน แทนการกด Request indexing หน้าเดิมซ้ำ เพราะการเปลี่ยนแปลงที่ทำให้ Google อยากเก็บหน้าคือคุณภาพของหน้า ไม่ใช่จำนวนครั้งที่ส่งคำขอ
หน้าแบบไหนไม่ต้องรีบแก้
หน้าที่ไม่ต้องรีบแก้คือหน้าที่ไม่ได้ตั้งใจให้คนค้นเจอ หรือเป็นสำเนาของหน้าหลักที่ถูก Index อยู่แล้ว คู่มือรายงาน Page indexing ระบุว่าเว็บส่วนใหญ่มีหน้าที่ไม่ถูก Index อยู่บ้าง แต่หน้าสำคัญทุกหน้าควรถูก Index และไม่ควรคาดหวังให้ทุก URL ถูก Index นอกจากหน้า Canonical หน้าต่อไปนี้จึงปล่อยไว้ได้
- Alternate page with proper canonical tag: Google ระบุว่าหน้านี้ชี้ไปที่หน้า Canonical ที่ถูก Index แล้วอย่างถูกต้อง จึงไม่ต้องทำอะไร
- Page with redirect: URL เก่าที่ Redirect ไปหน้าใหม่จะไม่ถูก Index เพราะหน้าปลายทางถูก Index แทน
- หน้าที่ตั้ง noindex โดยตั้งใจ: เช่น หน้าขอบคุณหลังกรอกฟอร์ม หน้าตะกร้าสินค้า หรือหน้าผลการค้นหาภายในเว็บ
- หน้า 404 ของเนื้อหาที่ลบไปแล้ว: ถ้าไม่มีหน้าใหม่ที่ตรงกันให้ Redirect ไป ปล่อยให้ตอบ 404 ได้
เริ่มจากกรองเฉพาะหน้าที่อยู่ใน Sitemap และเป็นหน้าที่สร้างรายได้หรือดึงผู้อ่านเข้าเว็บ เช่น หน้าบริการ หน้าสินค้า และบทความหลัก แล้วไล่แก้จากกลุ่มนั้นก่อน ถ้าเว็บมีหน้าสำคัญไม่ถูก Index จำนวนมากและไม่มีเวลาไล่ตรวจเอง ทีม Rankfinder ดูแลงานนี้ให้ได้ผ่านบริการดูแล SEO รายเดือน
ประเด็นสำคัญของการแก้หน้าเว็บไม่ถูก Index
- หน้าเว็บไม่ถูก Index คือหน้าที่ยังไม่อยู่ในดัชนีของ Google และ Google ระบุเองว่าการจัดทำดัชนีไม่มีการรับประกัน
- เช็กได้จากรายงาน Page indexing ใน Search Console โดยกรองเฉพาะ All submitted pages เพื่อดูหน้าที่ตั้งใจให้ติด
- Crawled – currently not indexed คือ Google อ่านแล้วแต่ยังไม่เก็บ สาเหตุหลักอยู่ที่ตัวหน้า เช่น เนื้อหาบาง ซ้ำ หรือลิงก์ภายในน้อย
- Discovered – currently not indexed คือ Google พบ URL แต่ยังไม่ได้อ่าน มักแก้ที่ความพร้อมของเซิร์ฟเวอร์และจำนวน URL ที่ไม่จำเป็น
- แก้ตามลำดับ: ทดสอบหน้าจริง เทียบ Canonical รวมหน้าซ้ำ เพิ่มเนื้อหาที่มีแต่หน้านี้ เพิ่มลิงก์ภายใน และใส่ไว้ใน Sitemap
- หลังแก้ใช้ Request indexing หรือ Validate fix เพียงครั้งเดียว แล้วรอผล เพราะการกดซ้ำไม่ทำให้เร็วขึ้น
- หน้า Redirect หน้า Alternate ที่มี Canonical ถูกต้อง และหน้าที่ตั้ง noindex โดยตั้งใจ ไม่ต้องแก้
อ่านต่อในหัวข้อเดียวกัน
- เว็บ WordPress ช้า แก้อย่างไร (เคสจริง: TTFB จาก 0.8 วิ เหลือ 0.07 วิ)
- Schema Markup คืออะไร? คู่มือใส่ Structured Data ให้เว็บไทย 2026
- SEO Audit คืออะไร? ตรวจเว็บอะไรบ้าง พร้อม Checklist
คำถามที่พบบ่อยเกี่ยวกับหน้าเว็บไม่ถูก Index
หน้าใหม่ไม่ถูก Index นานแค่ไหนถึงควรกังวล
Google ไม่ได้กำหนดระยะเวลาตายตัวว่าหน้าใหม่ต้องถูก Index ภายในกี่วัน คู่มือของ Google ระบุเพียงว่าการรวบรวมข้อมูลใช้เวลาตั้งแต่ไม่กี่วันถึงไม่กี่สัปดาห์ ถ้าหน้าสำคัญผ่านไปหลายสัปดาห์แล้วยังอยู่ในสถานะ Crawled – currently not indexed ให้เริ่มไล่ตรวจตามขั้นตอนในบทความนี้
กด Request indexing ซ้ำหลายครั้งช่วยให้ติดเร็วขึ้นไหม
กด Request indexing ซ้ำไม่ช่วยให้ติดเร็วขึ้น Google ระบุว่าการขอซ้ำหลายครั้งสำหรับ URL เดิมไม่ทำให้รวบรวมข้อมูลเร็วขึ้น และคำขอมีโควตาต่อวัน ควรกดหนึ่งครั้งหลังแก้หน้าเสร็จแล้วรอผล
ส่ง Sitemap แล้วทำไมหน้ายังไม่ถูก Index
ส่ง Sitemap แล้วหน้ายังไม่ถูก Index ได้ เพราะ Sitemap ช่วยให้ Google ค้นพบ URL แต่ไม่ได้บังคับให้เก็บเข้าดัชนี Google ยังตัดสินจากเนื้อหาและสัญญาณอื่นของหน้าเหมือนเดิม Sitemap จึงช่วยแก้ปัญหา Discovered ได้มากกว่าปัญหา Crawled
หน้าไม่ถูก Index ทำให้ทั้งเว็บอันดับตกไหม
หน้าไม่ถูก Index ไม่ได้ทำให้หน้าอื่นอันดับตกโดยตรง Google ระบุว่าเว็บส่วนใหญ่มีหน้าที่ไม่ถูก Index อยู่บ้าง สิ่งที่ต้องดูคือหน้าสำคัญทุกหน้าต้องถูก Index ถ้าหน้าบริการหรือบทความหลักหลายหน้าไม่ถูก Index พร้อมกัน ให้ตรวจเรื่องเนื้อหาซ้ำและโครงสร้างลิงก์ของทั้งเว็บ