การทำงานของ Google Search คือกระบวนการ 3 ขั้นที่ Google ใช้ค้นพบหน้าเว็บ เก็บข้อมูล และเลือกหน้าที่ตอบคำค้นได้ดีที่สุดมาแสดง ได้แก่ Crawl (การเก็บข้อมูล), Index (การจัดทำดัชนี) และ Serving หรือ Rank (การจัดอันดับและแสดงผล) ตามคู่มือวิธีการทำงานของ Google Search ของ Google เอง เมื่อรู้ว่า Google ทำงานอย่างไร เจ้าของเว็บจะบอกได้ว่าปัญหาเกิดที่ขั้นไหนและแก้ได้ตรงจุด บทความนี้อธิบายตามลำดับ ได้แก่ ภาพรวม 3 ขั้นตอนของ Google, Crawl คืออะไรและ Googlebot ค้นพบหน้าเว็บอย่างไร, Google อ่านหน้าเว็บที่ใช้ JavaScript อย่างไร, Index คืออะไรและ Google เลือกเก็บหน้าไหน, Google จัดอันดับผลการค้นหาอย่างไร, เจ้าของเว็บช่วยให้ Google ทำงานง่ายขึ้นได้อย่างไร และเหตุผลที่หน้าเว็บไม่ขึ้นใน Google
Google ทำงานอย่างไร: ภาพรวม 3 ขั้นตอน
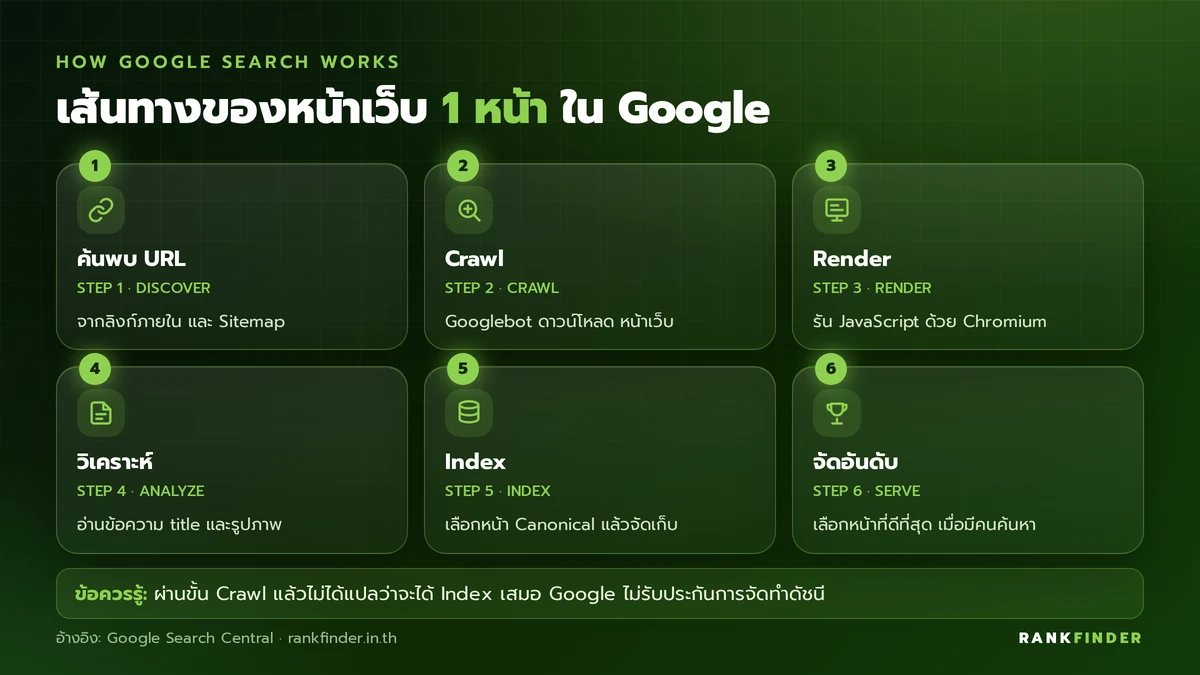
Google ทำงานด้วย 3 ขั้นต่อเนื่องกัน คือ Crawl เพื่อค้นพบและดาวน์โหลดหน้าเว็บ, Index เพื่อทำความเข้าใจและจัดเก็บหน้าเหล่านั้น และ Serving เพื่อเลือกหน้าที่เกี่ยวข้องที่สุดมาแสดงเมื่อมีคนค้นหา คู่มือของ Google ระบุว่าไม่ใช่ทุกหน้าจะผ่านครบทั้ง 3 ขั้น หน้าที่ไม่ถูก Crawl ก็ไม่มีโอกาสถูก Index และหน้าที่ไม่อยู่ใน Index ก็ไม่มีทางขึ้นผลการค้นหา งาน SEO ทุกอย่างจึงวางอยู่บนกระบวนการนี้ ถ้ายังไม่แน่ใจเรื่องพื้นฐานของ SEOและงานที่ครอบคลุม คู่มือหลักของเราอธิบายภาพรวมไว้ตั้งแต่ต้น ตารางด้านล่างสรุปว่าแต่ละขั้นเกิดอะไรขึ้น และเจ้าของเว็บควบคุมอะไรได้บ้าง
| ขั้นตอน | Google ทำอะไร | สิ่งที่เจ้าของเว็บควบคุมได้ |
|---|---|---|
| Crawl (เก็บข้อมูล) | Googlebot ค้นพบ URL จากลิงก์และ Sitemap แล้วดาวน์โหลดหน้า | ลิงก์ภายใน, Sitemap, robots.txt และความเร็วเซิร์ฟเวอร์ |
| Index (จัดทำดัชนี) | อ่านข้อความ แท็ก รูปภาพ เลือกหน้า Canonical แล้วจัดเก็บ | เนื้อหาที่ไม่ซ้ำ, แท็ก title, Canonical และ noindex |
| Serving (จัดอันดับและแสดงผล) | หาหน้าที่ตรงคำค้นใน Index แล้วเรียงตามความเกี่ยวข้องและคุณภาพ | เนื้อหาที่ตอบเจตนาการค้นหา, ความน่าเชื่อถือ และการใช้งานบนมือถือ |
Crawl คืออะไร และ Googlebot ค้นพบหน้าเว็บอย่างไร
Crawl คือขั้นที่โปรแกรมอัตโนมัติของ Google ชื่อ Googlebot เข้าไปดาวน์โหลดข้อความ รูปภาพ และวิดีโอจากหน้าเว็บที่ค้นพบ จุดเริ่มต้นของการ Crawl คือการค้นพบ URL เพราะGoogle ระบุว่าไม่มีทะเบียนกลางที่รวบรวมหน้าเว็บทั้งหมดไว้ Google จึงต้องค้นหาหน้าใหม่อยู่ตลอดเวลา วิธีหลักมี 2 ทาง คือไล่ตามลิงก์จากหน้าที่รู้จักอยู่แล้ว เช่น หน้าหมวดหมู่ที่ลิงก์ไปยังบทความใหม่ และอ่านรายการ URL จาก Sitemap ที่เจ้าของเว็บส่งให้
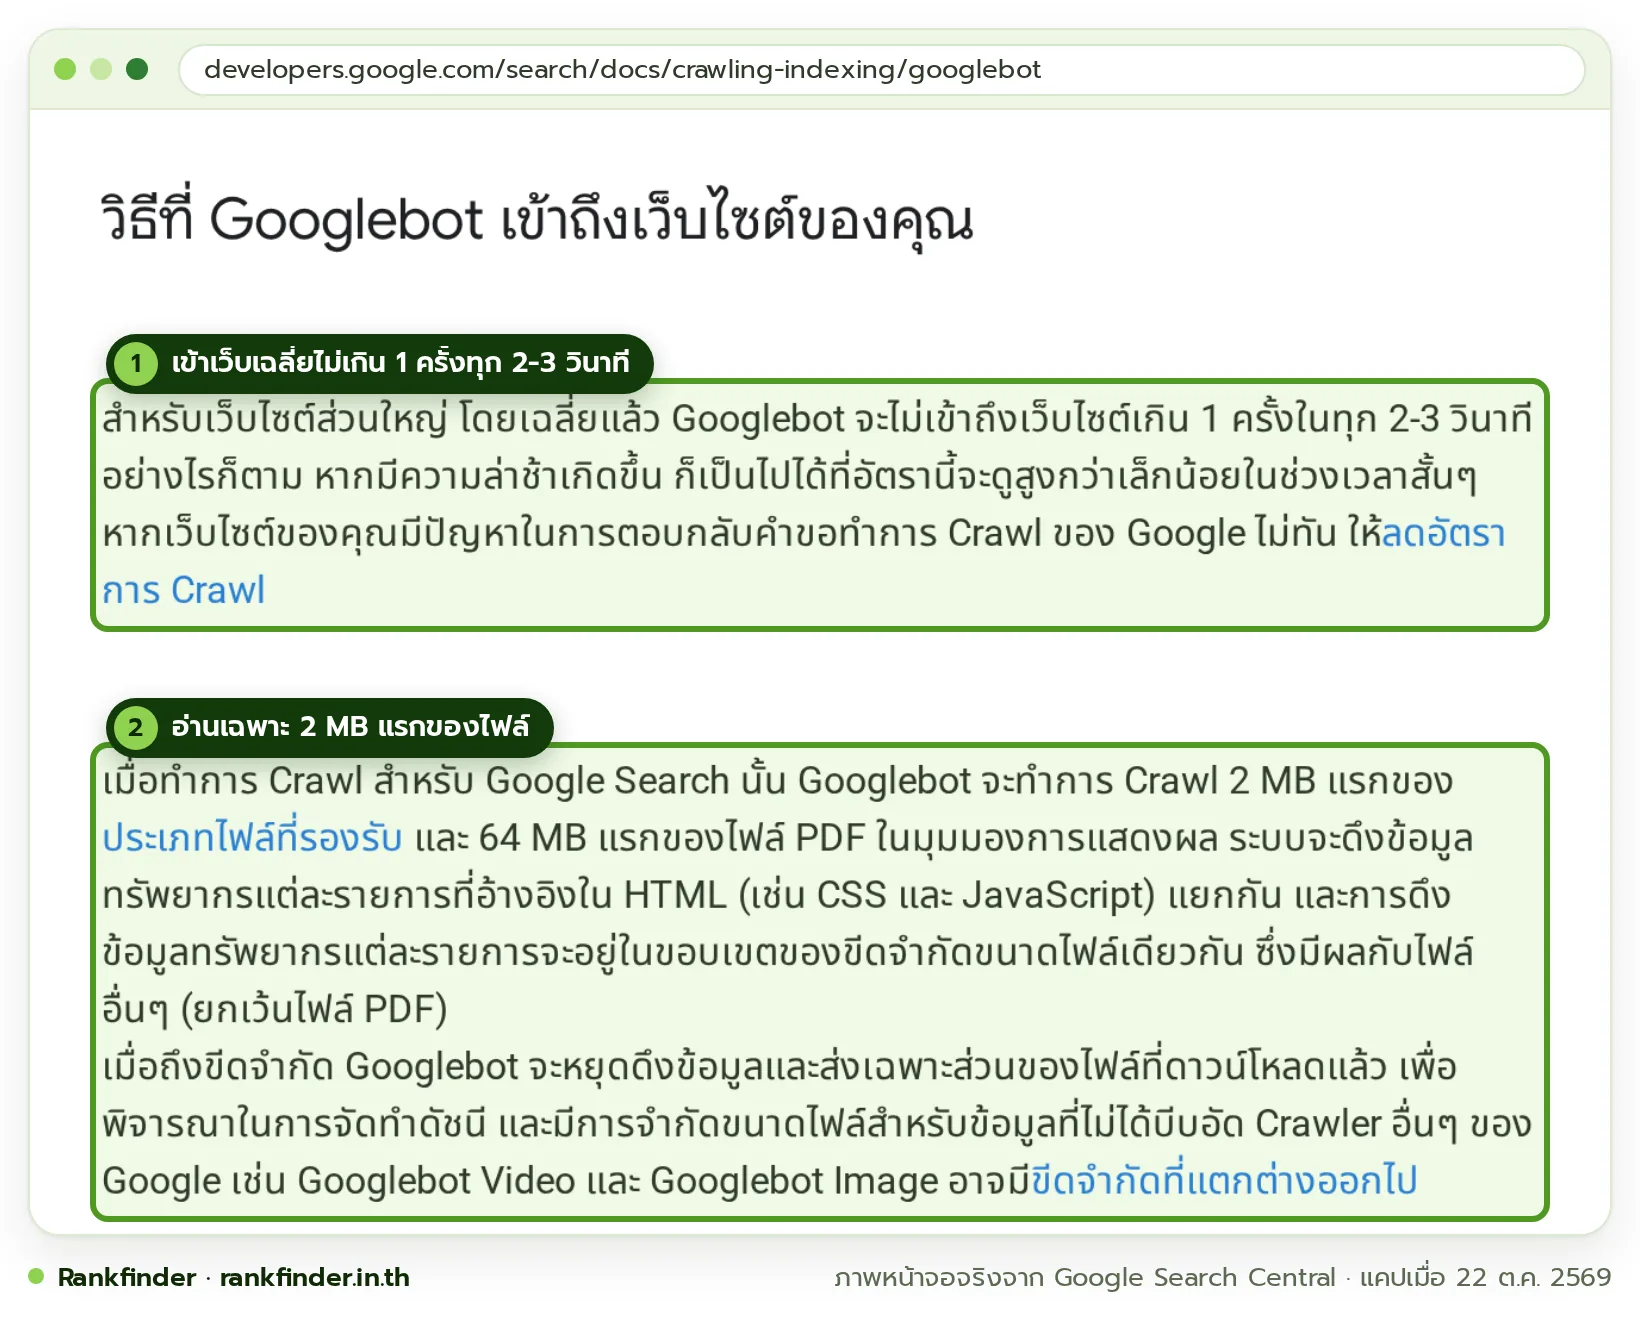
Googlebot ไม่ได้ Crawl ทุกหน้าที่ค้นพบ และไม่ได้เข้าเว็บถี่ที่สุดเท่าที่ทำได้ ระบบจะเลือกว่าจะ Crawl เว็บไหน บ่อยแค่ไหน และกี่หน้า โดยปรับความเร็วตามการตอบสนองของเซิร์ฟเวอร์ เช่น เมื่อเซิร์ฟเวอร์ตอบกลับด้วยข้อผิดพลาด HTTP 500 Googlebot จะชะลอการ Crawl ลง และตามเอกสาร Googlebot เว็บส่วนใหญ่ถูก Googlebot เข้าถึงโดยเฉลี่ยไม่เกินประมาณ 1 ครั้งทุก 2-3 วินาที
Googlebot มีกี่แบบ และอ่านหน้าเว็บได้แค่ไหน
Googlebot มี 2 แบบ คือ Googlebot สำหรับสมาร์ทโฟนที่จำลองผู้ใช้มือถือ และ Googlebot สำหรับเดสก์ท็อป เอกสาร Googlebot ระบุว่าเว็บส่วนใหญ่ถูก Index แบบ Mobile-first คำขอ Crawl ส่วนใหญ่จึงมาจาก Googlebot สมาร์ทโฟน เนื้อหาที่แสดงบนมือถือจึงเป็นเวอร์ชันที่ Google ใช้ประเมินเป็นหลัก อีกข้อที่ควรรู้คือ Googlebot จะ Crawl เฉพาะ 2 MB แรกของไฟล์ประเภทที่รองรับ เช่น HTML และ 64 MB แรกของไฟล์ PDF ส่วนที่เกินจากนี้จะไม่ถูกดาวน์โหลดและไม่ถูกนำไปพิจารณาตอน Index
ถ้าต้องการกันไม่ให้ Googlebot Crawl บางส่วนของเว็บ ให้ใช้ไฟล์ robots.txt แต่การบล็อก Crawl ไม่ได้กันไม่ให้ URL นั้นแสดงในผลการค้นหา ถ้าต้องการกันไม่ให้หน้าขึ้นผลการค้นหาต้องใช้คำสั่ง noindex แทน และอย่าบล็อก Googlebot เพียงเพราะเห็นชื่อในล็อก เพราะ user-agent ปลอมแปลงได้ง่าย เอกสาร Googlebot แนะนำให้ยืนยันก่อนด้วย Reverse DNS หรือเทียบกับช่วง IP ที่ Google เผยแพร่
Google อ่านหน้าเว็บที่ใช้ JavaScript อย่างไร
Google อ่านหน้าเว็บที่ใช้ JavaScript ด้วยการ Render หรือแสดงผลหน้าเว็บด้วย Chromium เวอร์ชันล่าสุด แบบเดียวกับที่เบราว์เซอร์แสดงหน้าให้คนเห็น คู่มือพื้นฐาน JavaScript SEO ของ Google อธิบายว่าเว็บที่ใช้ JavaScript ผ่าน 3 ช่วง คือ Crawl, Render และ Index โดย Googlebot จะนำทุกหน้าที่ตอบกลับด้วยสถานะ HTTP 200 เข้าคิวรอ Render ซึ่งอาจรอเพียงไม่กี่วินาทีหรือนานกว่านั้น
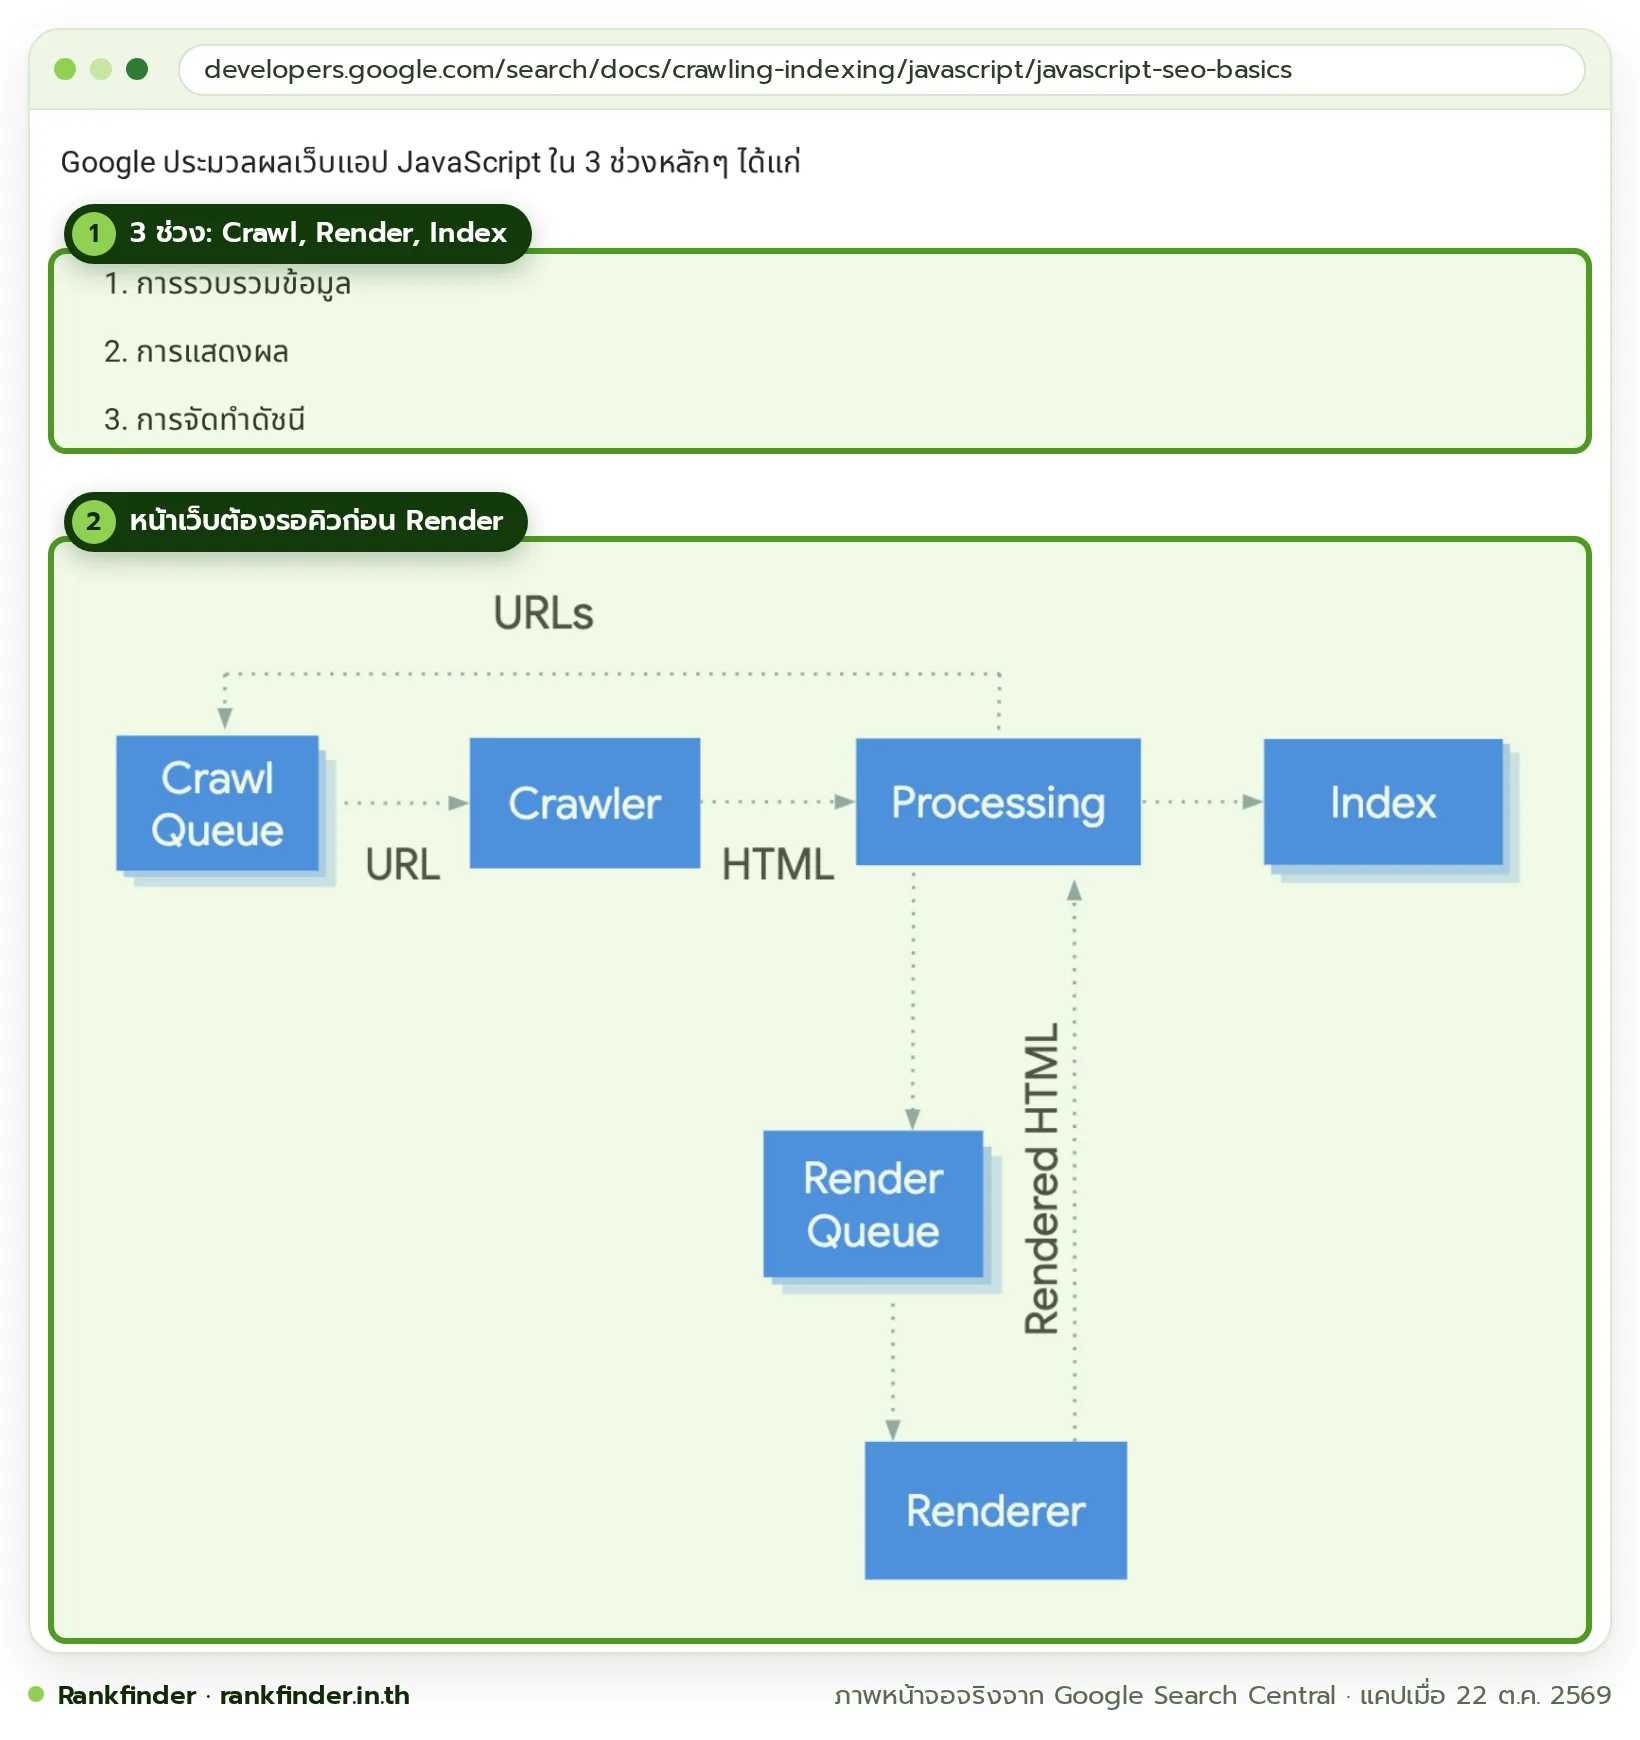
เรื่องนี้สำคัญเพราะเว็บจำนวนมากโหลดเนื้อหาหลักด้วย JavaScript ถ้าเนื้อหาปรากฏหลังจากสคริปต์ทำงานเท่านั้น Google จะเห็นเนื้อหานั้นเมื่อ Render สำเร็จแล้ว Google จึงยังแนะนำ Server-side rendering หรือ Pre-rendering เพราะทำให้หน้าเว็บเร็วขึ้นทั้งสำหรับผู้ใช้และ Crawler และบอทบางตัวรัน JavaScript ไม่ได้เลย สำหรับเว็บ WordPress ทั่วไป เนื้อหาบทความอยู่ใน HTML ตั้งแต่แรก ปัญหานี้จึงพบบ่อยกับเว็บแอปที่สร้างด้วยเฟรมเวิร์ก JavaScript มากกว่า
Index คืออะไร และ Google เลือกเก็บหน้าไหน
Index คือฐานข้อมูลขนาดใหญ่ที่ Google ใช้เก็บข้อมูลของหน้าเว็บที่วิเคราะห์แล้ว ส่วนการ Index คือขั้นที่ Google อ่านข้อความ แท็กสำคัญอย่าง <title> และ alt รวมถึงรูปภาพและวิดีโอ เพื่อเข้าใจว่าหน้านั้นพูดถึงอะไร Google เปรียบ Index ว่าเหมือนดัชนีท้ายเล่มของหนังสือที่มีรายการของทุกคำที่พบในทุกหน้าที่จัดเก็บ และระบุว่าดัชนีนี้ครอบคลุมหน้าเว็บหลายแสนล้านหน้า มีขนาดมากกว่า 100,000,000 กิกะไบต์
ระหว่าง Index Google จะจัดกลุ่มหน้าที่มีเนื้อหาคล้ายกันเข้าด้วยกัน แล้วเลือกหน้า Canonical หนึ่งหน้าเป็นตัวแทนของกลุ่ม หน้าอื่นในกลุ่มอาจถูกแสดงในบางบริบท เช่น เมื่อผู้ใช้ค้นหาจากมือถือหรือค้นหาหน้าที่เจาะจงมาก นอกจากนี้ Google ยังเก็บสัญญาณของหน้า Canonical เช่น ภาษา ประเทศที่เนื้อหามุ่งเป้า และความใช้งานง่าย ไว้ใช้ตอนแสดงผลการค้นหา
สิ่งที่หลายคนเข้าใจผิดคือหน้าที่ถูก Crawl แล้วต้องได้ Index เสมอ ความจริงคือGoogle ไม่รับประกันการจัดทำดัชนี หน้าที่ประมวลผลแล้วอาจไม่ถูกเก็บ สาเหตุที่พบบ่อยคือเนื้อหาคุณภาพต่ำ มีคำสั่ง robots meta ที่ไม่อนุญาตให้ Index หรือการออกแบบเว็บที่ทำให้ Index ได้ยาก
Google จัดอันดับผลการค้นหาอย่างไร
Google จัดอันดับผลการค้นหาด้วยระบบอัตโนมัติที่ดูปัจจัยและสัญญาณจำนวนมาก แล้วเลือกหน้าที่เกี่ยวข้องและมีคุณภาพสูงสุดจาก Index มาแสดงทันทีที่มีคนค้นหา หน้าวิธีจัดอันดับผลการค้นหาของ Google แบ่งปัจจัยหลักไว้ 5 กลุ่ม ดังนี้
- ความหมายของคำค้น: Google ตีความก่อนว่าผู้ค้นหาต้องการอะไร แม้คำที่พิมพ์จะไม่ชัดเจน
- ความเกี่ยวข้องของเนื้อหา: สัญญาณพื้นฐานที่สุดคือหน้ามีคำเดียวกับคำค้น และมีเนื้อหาที่เกี่ยวกับหัวข้อนั้นจริง
- คุณภาพของเนื้อหา: ในบรรดาหน้าที่เกี่ยวข้อง ระบบให้ความสำคัญกับหน้าที่ดูเป็นประโยชน์ที่สุด โดยดูสัญญาณด้านความเชี่ยวชาญ อำนาจ และความน่าเชื่อถือ
- ความใช้งานง่าย: เมื่อสัญญาณอื่นใกล้เคียงกัน หน้าที่คนเข้าถึงได้ง่ายกว่าอาจทำผลงานได้ดีกว่า
- บริบทและการตั้งค่า: ตำแหน่ง ประวัติการค้นหา และการตั้งค่าของผู้ใช้มีผลต่อผลลัพธ์ที่แต่ละคนเห็น
ปัจจัยเหล่านี้ทำงานผ่านระบบจัดอันดับหลายตัว คู่มือระบบจัดอันดับของ Google Search ระบุชื่อระบบที่ใช้งานอยู่ เช่น BERT และ Neural matching ที่ช่วยเข้าใจความหมายของคำค้น, RankBrain ที่เชื่อมคำกับแนวคิดแม้คำไม่ตรงกันทุกตัว, Passage ranking ที่ประเมินเนื้อหาทีละส่วนของหน้า, Link analysis และ PageRank ที่ดูว่าหน้าเว็บลิงก์หากันอย่างไร และระบบตรวจจับสแปมอย่าง SpamBrain ตัวอย่างจาก Google เองคือ คำค้น “ร้านซ่อมจักรยาน” ให้ผลลัพธ์ต่างกันระหว่างคนที่อยู่ปารีสกับคนที่อยู่ฮ่องกง เพราะตำแหน่งของผู้ค้นหาเป็นส่วนหนึ่งของความเกี่ยวข้อง
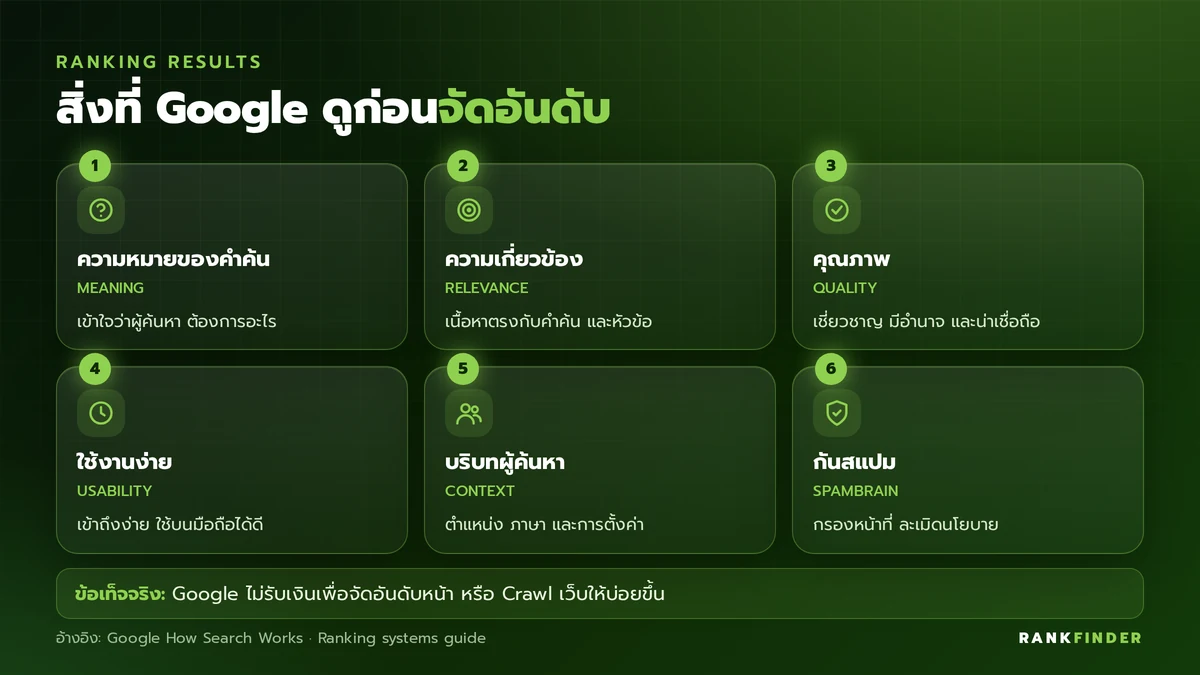
Google ระบุชัดว่าไม่รับเงินเพื่อจัดอันดับหน้าให้สูงขึ้น และไม่รับเงินเพื่อ Crawl เว็บให้บ่อยขึ้น การจัดอันดับทำโดยโปรแกรมทั้งหมด ส่วนโฆษณาที่เห็นบนหน้าผลการค้นหาเป็นระบบแยกที่มีป้ายกำกับว่าเป็นผู้สนับสนุน
เจ้าของเว็บช่วยให้ Google ทำงานง่ายขึ้นได้อย่างไร
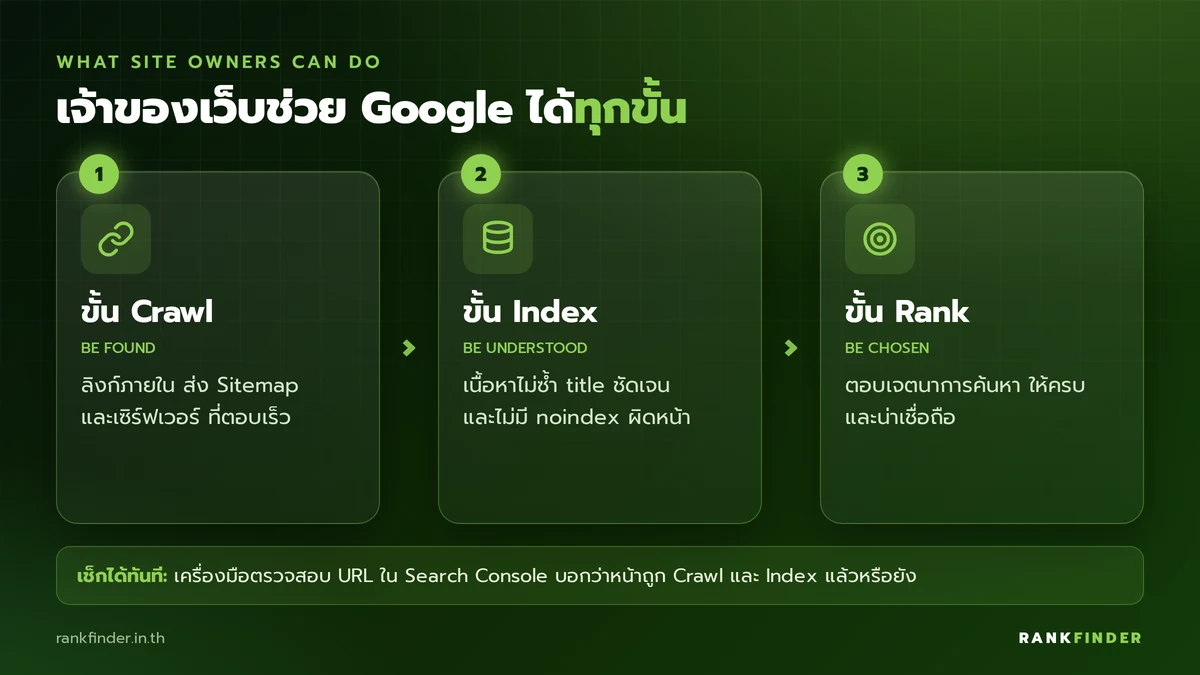
เจ้าของเว็บช่วยให้ Google ทำงานง่ายขึ้นได้ทุกขั้น ด้วยการทำให้หน้าเว็บค้นพบง่าย อ่านง่าย และตอบคำค้นได้ตรง งานด้านล่างเรียงตามขั้นตอนของ Google
- ขั้น Crawl: ทำลิงก์ภายในจากหน้าแรกและหน้าหมวดหมู่ไปยังหน้าใหม่ ส่ง Sitemap ใน Search Console และดูแลให้เซิร์ฟเวอร์ตอบกลับเร็วโดยไม่มีข้อผิดพลาด 5xx
- ขั้น Index: เขียนเนื้อหาที่ไม่ซ้ำกับหน้าอื่น ตั้งแท็ก title ให้ตรงหัวข้อ ใช้ Canonical กับหน้าที่ซ้ำกัน และตรวจว่าไม่มี noindex ติดอยู่ในหน้าที่ต้องการให้ขึ้น Google
- ขั้น Rank: ตอบเจตนาการค้นหาให้ครบ แสดงความเชี่ยวชาญจากประสบการณ์จริง และทำให้หน้าใช้งานบนมือถือได้ดี
ไฟล์ที่ควรตั้งให้ถูกตั้งแต่ต้นคือ robots.txt ซึ่งบอก Crawler ว่าส่วนไหนของเว็บเข้าได้หรือไม่ได้ การเขียนผิดเพียงบรรทัดเดียวอาจบล็อกทั้งเว็บไม่ให้ถูก Crawl
ความเร็วของเซิร์ฟเวอร์ก็มีผลกับขั้น Crawl เพราะ Googlebot ปรับความถี่ตามการตอบสนองของเว็บ เว็บ rankfinder.in.th เองเคยแก้ปัญหาเซิร์ฟเวอร์ตอบช้าเมื่อ 26 กันยายน 2026 ทำให้ TTFB หรือเวลาที่เซิร์ฟเวอร์เริ่มส่งข้อมูลกลับ ลดจากประมาณ 0.8 วินาทีเหลือประมาณ 0.07 วินาที หน้าเว็บจึงตอบสนองเร็วขึ้นทั้งสำหรับผู้อ่านและ Googlebot หลังแก้ไขหน้าใดก็ตาม ใช้เครื่องมือตรวจสอบ URL ใน Search Console เพื่อดูสถานะและขอให้ Google Crawl ใหม่ได้ โดยคู่มือของ Google ระบุว่าการ Crawl อาจใช้เวลาตั้งแต่ 2-3 วันไปจนถึง 2-3 สัปดาห์ และการขอซ้ำหลายครั้งไม่ช่วยให้เร็วขึ้น
เหตุผลที่หน้าเว็บไม่ขึ้นใน Google
หน้าเว็บไม่ขึ้นใน Google เพราะติดอยู่ที่ขั้นใดขั้นหนึ่งใน 3 ขั้น การไล่หาสาเหตุตามลำดับขั้นจึงเร็วที่สุด
- ยังไม่ถูกค้นพบ: หน้าไม่มีลิงก์ภายในชี้เข้า และไม่อยู่ใน Sitemap Googlebot จึงไม่รู้ว่ามีหน้านี้
- ถูกบล็อกการ Crawl: robots.txt ห้ามเข้า เซิร์ฟเวอร์ล่ม หรือหน้าต้องล็อกอินก่อน
- ถูก Crawl แต่ไม่ถูก Index: เนื้อหาบาง ซ้ำกับหน้าอื่น หรือมีคำสั่ง noindex
- อยู่ใน Index แต่ไม่ติดอันดับ: เนื้อหาไม่ตรงกับคำที่คนค้น หรือมีหน้าอื่นตอบได้ดีกว่า ซึ่ง Google ระบุว่าเป็นเหตุผลที่ Search Console อาจแจ้งว่าหน้าถูก Index แล้วแต่ยังไม่เห็นในผลการค้นหา
กรณีที่พบบ่อยที่สุดของปัญหาเว็บไม่ขึ้น Googleคือหน้าค้างอยู่ในสถานะ Crawled – currently not indexed หรือ Discovered – currently not indexed ใน Search Console ซึ่งแต่ละสถานะเกิดจากสาเหตุต่างกันและแก้คนละวิธี
ความเข้าใจว่า Google ทำงานอย่างไรเป็นพื้นฐานของงาน SEO ทุกส่วน ตั้งแต่การวางโครงสร้างเว็บไปจนถึงการเขียนบทความ ถ้าอยากฝึกอ่านข้อมูล Crawl และ Index จากเว็บจริงพร้อมคนคอยตรวจงาน หลักสูตร SEO ของ Rankfinder สอนแบบลงมือทำทีละขั้น
ประเด็นสำคัญของการทำงานของ Google
- ภาพรวม 3 ขั้นตอน: Google ทำงานแบบ Crawl, Index และ Serving และไม่ใช่ทุกหน้าจะผ่านครบทั้ง 3 ขั้น
- Crawl: Googlebot ค้นพบ URL จากลิงก์และ Sitemap ส่วนใหญ่ Crawl ด้วยเวอร์ชันสมาร์ทโฟน และอ่านเฉพาะ 2 MB แรกของไฟล์ HTML
- JavaScript: Google Render หน้าด้วย Chromium เวอร์ชันล่าสุด แต่ Server-side rendering ยังเป็นทางที่ปลอดภัยกว่า
- Index: Google วิเคราะห์เนื้อหา เลือกหน้า Canonical จากหน้าที่ซ้ำกัน และไม่รับประกันว่าทุกหน้าจะถูก Index
- Rank: ระบบดูความหมายของคำค้น ความเกี่ยวข้อง คุณภาพ ความใช้งานง่าย และบริบทของผู้ค้นหา โดยไม่รับเงินเพื่อจัดอันดับ
- สิ่งที่เจ้าของเว็บทำได้: ลิงก์ภายใน, Sitemap, เซิร์ฟเวอร์ที่ตอบเร็ว, เนื้อหาไม่ซ้ำ และเนื้อหาที่ตอบเจตนาการค้นหา
- หน้าไม่ขึ้น Google: ไล่ตรวจทีละขั้น ตั้งแต่ถูกค้นพบหรือไม่ ถูกบล็อกหรือไม่ ถูก Index หรือไม่ ไปจนถึงเนื้อหาตรงคำค้นหรือไม่
อ่านต่อในหัวข้อเดียวกัน
- On-Page, Off-Page และ Technical SEO ต่างกันอย่างไร
- SEO กับ Google Ads (SEM) ต่างกันอย่างไร ธุรกิจควรเลือกแบบไหน
- ทำ SEO นานแค่ไหนถึงเห็นผล? ไทม์ไลน์จริงจากกรณีศึกษา
- SEO สายขาว vs สายดำ: ความเสี่ยงที่เจ้าของเว็บต้องรู้
- On-Page SEO Checklist: ตรวจ Title, Meta, Heading และรูปภาพก่อนเผยแพร่
- ทำ SEO เว็บ WordPress ด้วยตัวเอง + ตั้งค่า Rank Math ทีละขั้น
คำถามที่พบบ่อยเกี่ยวกับการทำงานของ Google
Crawl กับ Index ต่างกันอย่างไร
Crawl คือการที่ Googlebot เข้าไปดาวน์โหลดหน้าเว็บ ส่วน Index คือการที่ Google วิเคราะห์หน้านั้นแล้วเลือกเก็บไว้ในฐานข้อมูลสำหรับแสดงผลการค้นหา หน้าที่ถูก Crawl แล้วจึงอาจยังไม่ถูก Index ได้ ถ้า Google มองว่าเนื้อหาซ้ำกับหน้าอื่นหรือคุณภาพยังไม่พอ
หน้าเว็บใหม่ใช้เวลานานแค่ไหนกว่า Google จะเห็น
หน้าเว็บใหม่อาจใช้เวลาตั้งแต่ 2-3 วันไปจนถึง 2-3 สัปดาห์กว่าจะถูก Crawl ตามคู่มือการขอให้ Google Crawl ใหม่ ระยะเวลาขึ้นกับว่า Google ค้นพบหน้าได้ง่ายแค่ไหน การมีลิงก์ภายในจากหน้าที่มีอยู่แล้วและการส่ง Sitemap ช่วยให้ Google รู้จักหน้าใหม่ได้เร็วขึ้น
จ่ายเงินให้ Google เพื่อให้ติดอันดับได้ไหม
จ่ายเงินให้ Google เพื่อให้ติดอันดับในผลการค้นหาแบบออร์แกนิกไม่ได้ Google ระบุว่าไม่รับเงินเพื่อจัดอันดับหน้าให้สูงขึ้นหรือ Crawl เว็บให้บ่อยขึ้น ถ้าต้องการพื้นที่แบบจ่ายเงินต้องใช้ Google Ads ซึ่งแสดงเป็นโฆษณาที่มีป้ายกำกับแยกจากผลการค้นหาปกติ
Googlebot มองเห็นหน้าเว็บเหมือนคนทั่วไปไหม
Googlebot มองเห็นหน้าเว็บใกล้เคียงกับคนทั่วไป เพราะ Google Render หน้าด้วย Chromium เวอร์ชันล่าสุดและรัน JavaScript ได้ แต่ Googlebot เข้าหน้าที่ต้องล็อกอินไม่ได้ และอ่านเฉพาะ 2 MB แรกของไฟล์ HTML เนื้อหาหลังหน้าล็อกอินหรือเนื้อหาที่อยู่เกินขนาดนี้จึงไม่ถูกนำไป Index